深入探究Python中变量的拷贝和作用域问题
在 python 中赋值语句总是建立对象的引用值,而不是复制对象。因此,python 变量更像是指针,而不是数据存储区域,
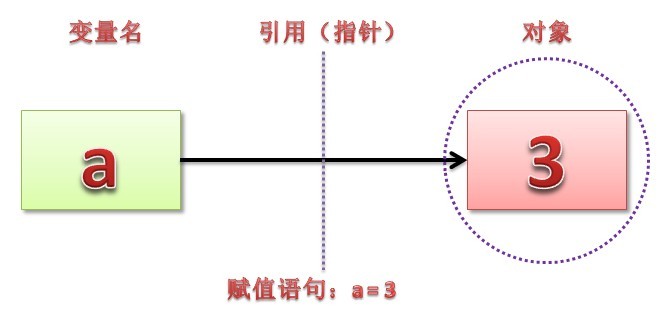
这点和大多数 OO 语言类似吧,比如 C++、java 等 ~
1、先来看个问题吧:
在Python中,令values=[0,1,2];values[1]=values,为何结果是[0,[...],2]?
>>> values = [0, 1, 2]
>>> values[1] = values
>>> values
[0, [...], 2]
我预想应当是
[0, [0, 1, 2], 2]
但结果却为何要赋值无限次?
可以说 Python 没有赋值,只有引用。你这样相当于创建了一个引用自身的结构,所以导致了无限循环。为了理解这个问题,有个基本概念需要搞清楚。
Python 没有「变量」,我们平时所说的变量其实只是「标签」,是引用。
执行
values = [0, 1, 2]
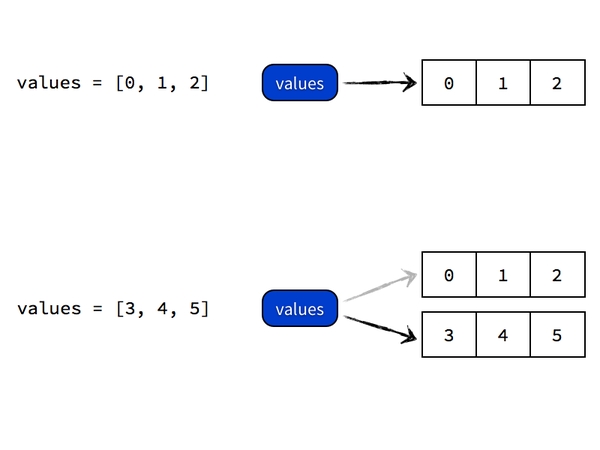
的时候,Python 做的事情是首先创建一个列表对象 [0, 1, 2],然后给它贴上名为 values 的标签。如果随后又执行
values = [3, 4, 5]
的话,Python 做的事情是创建另一个列表对象 [3, 4, 5],然后把刚才那张名为 values 的标签从前面的 [0, 1, 2] 对象上撕下来,重新贴到 [3, 4, 5] 这个对象上。
至始至终,并没有一个叫做 values 的列表对象容器存在,Python 也没有把任何对象的值复制进 values 去。过程如图所示:
执行
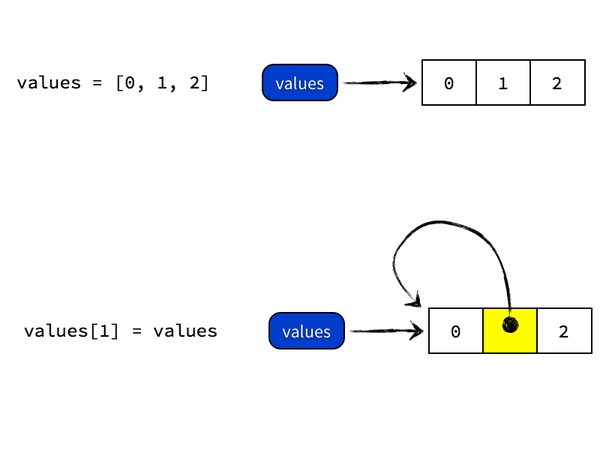
的时候,Python 做的事情则是把 values 这个标签所引用的列表对象的第二个元素指向 values
所引用的列表对象本身。执行完毕后,values 标签还是指向原来那个对象,只不过那个对象的结构发生了变化,从之前的列表 [0, 1, 2]
变成了 [0, ?, 2],而这个 ? 则是指向那个对象本身的一个引用。如图所示:
要达到你所需要的效果,即得到 [0, [0, 1, 2], 2] 这个对象,你不能直接将 values[1] 指向 values
引用的对象本身,而是需要吧 [0, 1, 2] 这个对象「复制」一遍,得到一个新对象,再将 values[1]
指向这个复制后的对象。Python 里面复制对象的操作因对象类型而异,复制列表 values 的操作是
values[:] #生成对象的拷贝或者是复制序列,不再是引用和共享变量,但此法只能顶层复制
所以你需要执行
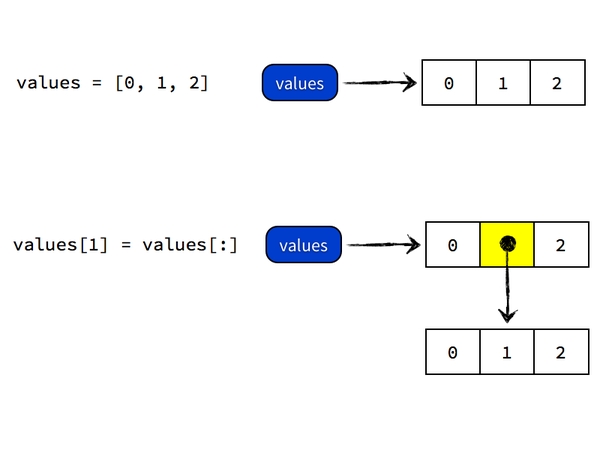
Python 做的事情是,先 dereference 得到 values 所指向的对象 [0, 1, 2],然后执行 [0, 1,
2][:] 复制操作得到一个新的对象,内容也是 [0, 1, 2],然后将 values
所指向的列表对象的第二个元素指向这个复制二来的列表对象,最终 values 指向的对象是 [0, [0, 1, 2], 2]。过程如图所示:
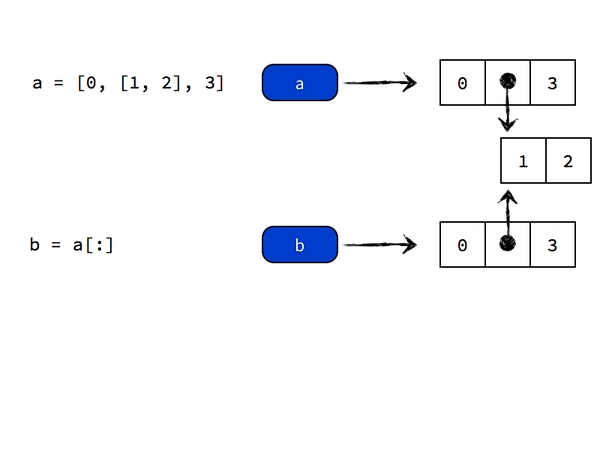
往更深处说,values[:] 复制操作是所谓的「浅复制」(shallow copy),当列表对象有嵌套的时候也会产生出乎意料的错误,比如
a=[0, [1,2],3]
b=a[:]
a[0]=8
a[1][1]=9
问:此时 a 和 b 分别是多少?
正确答案是 a 为 [8, [1, 9], 3],b 为 [0, [1, 9], 3]。发现没?b 的第二个元素也被改变了。想想是为什么?不明白的话看下图
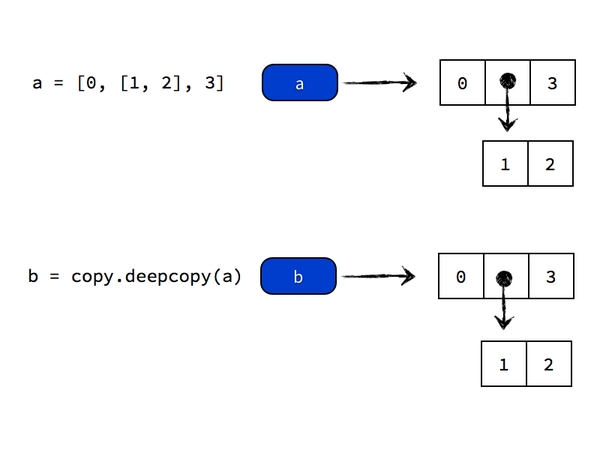
正确的复制嵌套元素的方法是进行「深复制」(deep copy),方法是
importcopy
a=[0, [1,2],3]
b=copy.deepcopy(a)
a[0]=8
a[1][1]=9
2、引用 VS 拷贝:
(1)没有限制条件的分片表达式(L[:])能够复制序列,但此法只能浅层复制。
(2)字典 copy 方法,D.copy() 能够复制字典,但此法只能浅层复制
(3)有些内置函数,例如 list,能够生成拷贝 list(L)
(4)copy 标准库模块能够生成完整拷贝:deepcopy 本质上是递归 copy
(5)对于不可变对象和可变对象来说,浅复制都是复制的引用,只是因为复制不变对象和复制不变对象的引用是等效的(因为对象不可变,当改变时会新建对象重新赋值)。所以看起来浅复制只复制不可变对象(整数,实数,字符串等),对于可变对象,浅复制其实是创建了一个对于该对象的引用,也就是说只是给同一个对象贴上了另一个标签而已。
L = [1, 2, 3]
D = {'a':1, 'b':2}
A = L[:]
B = D.copy()
print "L, D"
print L, D
print "A, B"
print A, B
print "--------------------"
A[1] = 'NI'
B['c'] = 'spam'
print "L, D"
print L, D
print "A, B"
print A, B
L, D
[1, 2, 3] {'a': 1, 'b': 2}
A, B
[1, 2, 3] {'a': 1, 'b': 2}
--------------------
L, D
[1, 2, 3] {'a': 1, 'b': 2}
A, B
[1, 'NI', 3] {'a': 1, 'c': 'spam', 'b': 2}
3、增强赋值以及共享引用:
x = x + y,x 出现两次,必须执行两次,性能不好,合并必须新建对象 x,然后复制两个列表合并
属于复制/拷贝
x += y,x 只出现一次,也只会计算一次,性能好,不生成新对象,只在内存块末尾增加元素。
当 x、y 为list时, += 会自动调用 extend 方法进行合并运算,in-place change。
属于共享引用
L = [1, 2]
M = L
L = L + [3, 4]
print L, M
print "-------------------"
L = [1, 2]
M = L
L += [3, 4]
print L, M
[1, 2, 3, 4] [1, 2]
-------------------
[1, 2, 3, 4] [1, 2, 3, 4]
4、python 从2.x 到3.x,语句变函数引发的变量作用域问题
先看段代码:
def test():
a = False
exec ("a = True")
print ("a = ", a)
test()
b = False
exec ("b = True")
print ("b = ", b)
在 python 2.x 和 3.x 下 你会发现他们的结果不一样:
2.x:
a = True
b = True
3.x:
a = False
b = True
这是为什么呢?
因为 3.x 中 exec 由语句变成函数了,而在函数中变量默认都是局部的,也就是说
你所见到的两个 a,是两个不同的变量,分别处于不同的命名空间中,而不会冲突。
具体参考 《learning python》P331-P332
知道原因了,我们可以这么改改:
def test():
a = False
ldict = locals()
exec("a=True",globals(),ldict)
a = ldict['a']
print(a)
test()
b = False
exec("b = True", globals())
print("b = ", b)
这个问题在 stackoverflow 上已经有人问了,而且 python 官方也有人报了 bug。。。


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330