你有没有想过,手机里点外卖、刷社交软件、转一笔账,背后到底是谁在替你"记着账"?
答案其实很简单:数据库,以及跟它对话的那门语言——SQL。
这篇文章就是为完全没接触过数据库的你写的。跟着读下去,你会明白 SQL 到底是什么、为什么它和 Python、JavaScript 不一样、最常用的几条命令怎么写,以及怎样用 4 周时间从零基础练到能应付大多数技术面试。
一、为什么每个开发者都该学 SQL
SQL(Structured Query Language,结构化查询语言)是用来和数据库"说话"的语言。
几乎所有存数据的应用,背后都跑着 SQL——社交平台、银行系统,甚至是你中午用来点午餐的那个 App。
和大多数编程语言不同,SQL 不负责画界面,也不负责写算法。它的使命很纯粹:向数据提问,并得到精确的答案。
只要你能用中文把问题说清楚,你就能学会用 SQL 把它"翻译"出来。
二、SQL 和别的编程语言不一样
如果你学过 JavaScript 或 Python,刚接触 SQL 会觉得它"怪怪的"。但恰恰是这种"怪",对初学者非常友好。
SQL 是声明式的语言:你描述"想要什么",而不是"怎么得到它"。
在 JavaScript 里,你可能会写一个循环去过滤数组;在 SQL 里,你只要写一句 WHERE 条件,剩下的"怎么高效找到这些行"交给数据库自己去操心。
这让 SQL 在很多方面都更好学。基本操作都很直观,语法读起来几乎像英语:
SELECT name, email
FROM users
WHERE age > 25
ORDER BY name;
就算你完全不懂 SQL,大概也能猜出这句在干嘛:把 25 岁以上用户的姓名和邮箱取出来,按字母顺序排列。
三、SQL 的五大核心操作
你这辈子会写到的每一条 SQL 查询,几乎都是由下面这五个操作搭出来的。把它们练熟,绝大多数数据问题你都能答上来。
1. SELECT:挑选列
SELECT 用来指定你想看哪些列。
SELECT * FROM products;
SELECT name, price FROM products;
SELECT name AS product_name,
price AS unit_price
FROM products;
2. WHERE:筛选行
WHERE 把结果缩小到符合某个条件的行。
SELECT * FROM users WHERE city = 'New York';
SELECT * FROM products WHERE price > 50;
SELECT * FROM users
WHERE age >= 18 AND city = 'London';
SELECT * FROM users
WHERE email LIKE '%@gmail.com';
SELECT * FROM orders
WHERE status IN ('pending', 'processing');
3. JOIN:把多张表拼起来
真实的数据库会把数据分散在多张表里,JOIN 负责把它们合到一起。
想象有两张表:users(id, name, email)和 orders(id, user_id, total, date)。想看"谁买了什么":
SELECT users.name, orders.total, orders.date
FROM users
JOIN orders ON users.id = orders.user_id;
上面这是 INNER JOIN(内连接),只显示至少下过一单的用户。如果你想看到所有用户、包括没下过单的:
SELECT users.name, orders.total
FROM users
LEFT JOIN orders ON users.id = orders.user_id;
没有订单的用户,在 total 这一列会显示 NULL。
4. GROUP BY:汇总数据
GROUP BY 把行"折叠"成一个个分组,让你能计算聚合结果。
SELECT city, COUNT(*) AS user_count
FROM users
GROUP BY city;
SELECT user_id, AVG(total) AS avg_order
FROM orders
GROUP BY user_id;
SELECT DATE_TRUNC('month', date) AS month,
SUM(total) AS revenue
FROM orders
GROUP BY DATE_TRUNC('month', date)
ORDER BY month;
5. ORDER BY:给结果排序
ORDER BY 负责安排输出的顺序。
SELECT * FROM users ORDER BY name;
SELECT * FROM products ORDER BY price DESC;
SELECT * FROM users ORDER BY city, name;
SELECT * FROM products
ORDER BY price DESC
LIMIT 10;
四、一步步把查询写出来
初学者最容易犯的错,就是想一口气写出一条超复杂的查询。正确的做法,是一层一层往上叠:
问题:"2025 年总营收最高的前 5 个城市是哪些?"
第 1 步:先看原始数据。
SELECT * FROM orders;
第 2 步:筛出 2025 年的。
SELECT * FROM orders
WHERE date >= '2025-01-01' AND date < '2026-01-01';
第 3 步:连上 users 表,拿到城市信息。
SELECT users.city, orders.total
FROM orders
JOIN users ON orders.user_id = users.id
WHERE orders.date >= '2025-01-01'
  AND orders.date < '2026-01-01';
第 4 步:按城市分组,把金额加起来。
SELECT users.city, SUM(orders.total) AS revenue
FROM orders
JOIN users ON orders.user_id = users.id
WHERE orders.date >= '2025-01-01'
  AND orders.date < '2026-01-01'
GROUP BY users.city;
第 5 步:排序并取前 5。
SELECT users.city, SUM(orders.total) AS revenue
FROM orders
JOIN users ON orders.user_id = users.id
WHERE orders.date >= '2025-01-01'
  AND orders.date < '2026-01-01'
GROUP BY users.city
ORDER BY revenue DESC
LIMIT 5;
每一步都能单独运行、验证结果是否合理,再往上加下一层。这种"搭积木"的写法,比憋大招稳得多。
五、初学者最常踩的 4 个坑
坑 1:该用 HAVING 时用了 WHERE
WHERE 是在分组之前过滤单行;HAVING 是在分组之后过滤分组。
SELECT city, COUNT(*) FROM users
WHERE COUNT(*) > 10
GROUP BY city;
SELECT city, COUNT(*) FROM users
GROUP BY city
HAVING COUNT(*) > 10;
坑 2:忘了处理 NULL
NULL 不等于 0,也不等于空字符串。它表示"未知"或"缺失"。
SELECT * FROM users WHERE phone = NULL;
SELECT * FROM users WHERE phone IS NULL;
坑 3:JOIN 时列名不明确
两张表都有同名列时,必须指明你指的是哪张表的列。
SELECT id, name FROM users JOIN orders ON users.id = orders.user_id;
SELECT users.id, users.name FROM users JOIN orders ON users.id = orders.user_id;
坑 4:不用表别名
别名让查询更短、更易读,尤其在 JOIN 多张表时。
SELECT users.name, orders.total
FROM users
JOIN orders ON users.id = orders.user_id;
SELECT u.name, o.total
FROM users u
JOIN orders o ON u.id = o.user_id;
六、数据分析师 vs 后端开发,用法大不同
同样是 SQL,不同岗位用起来侧重点不一样。
数据分析师主要用 SQL 来:
核心技能:复杂的 JOIN、窗口函数、CTE(公用表表达式)、日期处理、聚合。
后端开发主要用 SQL 来:
核心技能:表结构设计、索引、事务、范式化、查询优化。
不管你走哪条路,基本功都是一样的。把 SELECT、WHERE、JOIN、GROUP BY、ORDER BY 学透,两条路的地基就都打好了。
七、零基础 4 周练习计划
第 1 周:SELECT 和 WHERE
- 用上 AND、OR、NOT、IN、BETWEEN、LIKE
- 用 IS NULL / IS NOT NULL 处理空值
第 2 周:JOIN
第 3 周:聚合
第 4 周:子查询与进阶
- 窗口函数(ROW_NUMBER、RANK、LAG、LEAD)
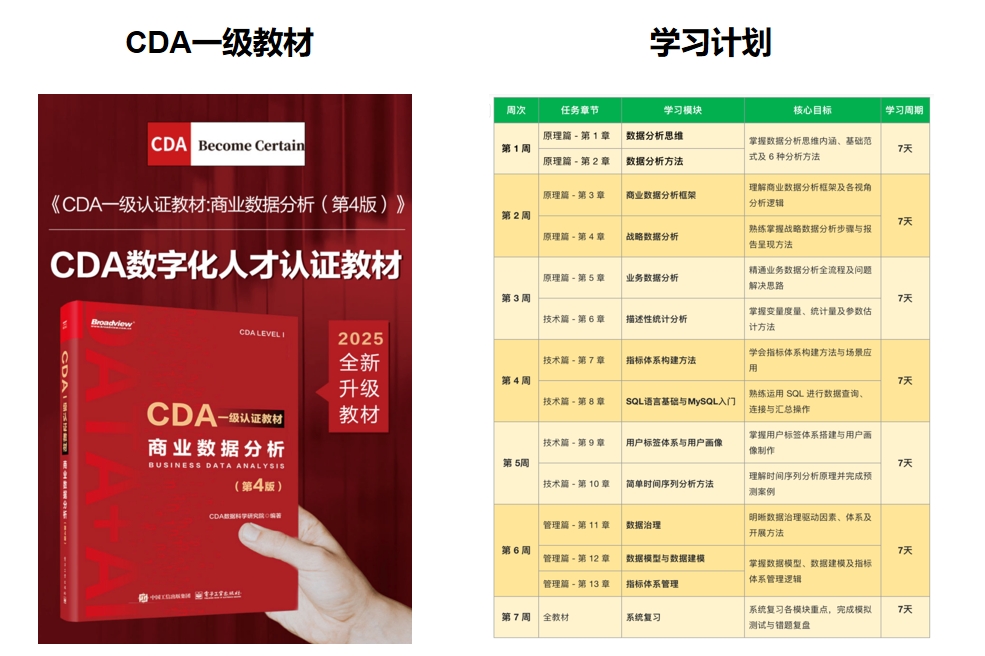
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330