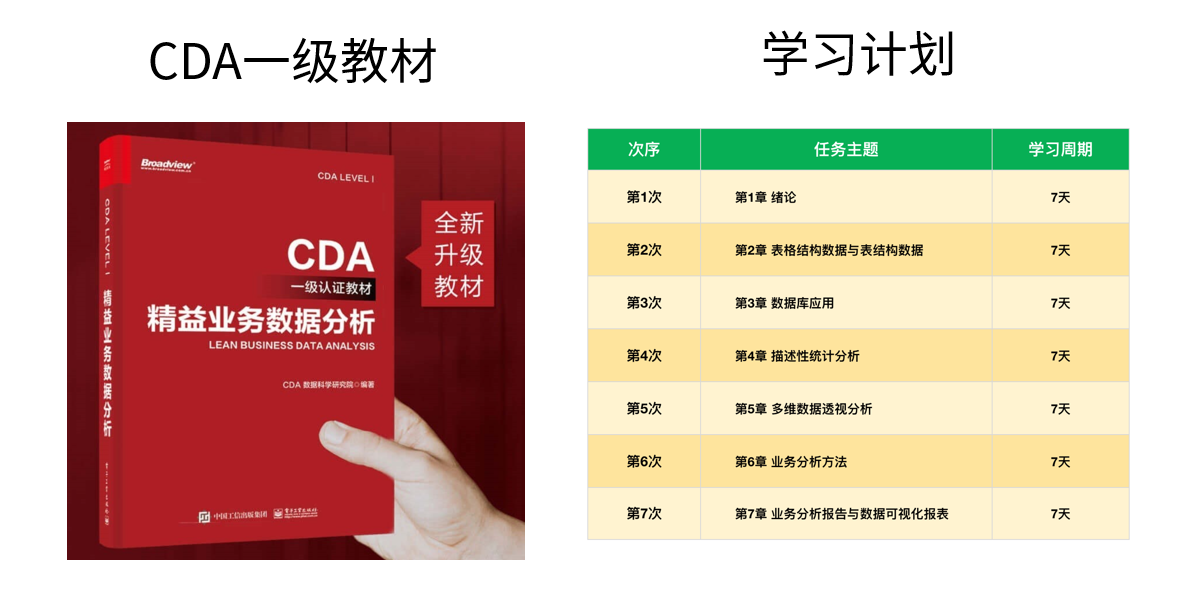
大数据正以多方面方式深刻影响着企业的决策过程,不仅改变了决策手段,更提升了效率和准确性。让我们深入探讨大数据在企业决策中的作用。 提高决策效率和准确性 大数据通过数据分析、预测建模、自动化流程与实时决策 ...
2024-12-06在大数据生命周期中,数据清洗和转换是至关重要的步骤,对于确保数据质量和可用性起着关键作用。这两个阶段相辅相成,为数据分析和决策提供坚实基础。 数据清洗:确保数据准确性与完整性 数据清洗是识别和处理数据中 ...
2024-12-06数据清洗和转换在大数据生命周期中扮演着关键角色,确保数据质量和可用性。数据清洗涉及识别和处理数据中的错误、缺失值和重复值。这一过程包括错误检测与修复(如异常值处理)、缺失值处理(删除或填充)、数据标准 ...
2024-12-06单因素方差分析(One-way ANOVA)是一种统计方法,用于检验多个组之间均值是否存在显著差异。在这个过程中,假设检验起着核心作用,通过比较不同组的均值来判断因素对结果的影响是否显著。 假设检验与结果 在单因素 ...
2024-12-06对比RNN和CNN的性能 在探讨卷积神经网络(Convolutional Neural Networks,CNN)和循环神经网络(Recurrent Neural Networks,RNN)的性能时,我们必须深入了解它们在不同领域的适用性和优势。 适用领域 CNN CNN擅长 ...
2024-12-06在社会科学研究中,统计方法扮演着至关重要的角色。其中,方差分析(ANOVA)作为一种比较不同组别间差异的工具,在人群行为、经济数据和社会现象研究中发挥着重要作用。让我们深入探讨方差分析在社会科学领域中的应 ...
2024-12-06在统计学中,非参数检验是一种关键的工具,用于对总体分布未知或不满足参数检验条件的情况下进行推断。相较于参数检验,非参数检验更加灵活,适用范围更广泛,特别适合处理名义或序数数据类型。本文将介绍非参数检验 ...
2024-12-06在推荐系统中,协同过滤(Collaborative Filtering)是一项核心技术,旨在通过分析用户之间的相似性或项目之间的相似性,实现个性化推荐。这种算法主要分为两大类:基于用户的协同过滤(User-Based Collaborative Fi ...
2024-12-06在统计学中,假设检验是一种系统性流程,用于评估样本数据是否支持或拒绝特定假设。通过以下操作步骤和不同类型的假设检验,我们可以深入探讨这一重要概念。 理解操作步骤 提出假设 首先,明确要检验的原假设(H0) ...
2024-12-06数据分析世界中,概率分布扮演着至关重要的角色,其中卡方分布(χ²分布)作为一种经常被运用的分布,在其特性和与其他分布的异同中展现出独特之处。让我们深入探讨卡方分布的特点以及它与其他分布之间的对比。 非 ...
2024-12-06理解模型过拟合 模型过拟合是指机器学习模型在训练数据上表现出色,但在新数据或未见过的数据上表现不佳的现象。这通常是因为模型过于复杂,捕捉到了训练数据中的噪声而非内在模式,导致泛化能力下降。 简化模型复杂 ...
2024-12-06在数据分析领域,判别分析是一项重要的多变量统计分析方法。它能够在已知分类情况下,根据研究对象的特征值判断其类型归属。本文将探讨判别分析的数学基础、常用方法及应用,并解释其重要性和实际意义。 判别分析的 ...
2024-12-06
欠拟合是机器学习和统计建模中一个常见但棘手的问题。其核心在于模型过于简单,无法完整捕捉数据中的复杂关系,导致模型在训练数据和新数据上表现不佳。让我们深入探讨欠拟合的数学原理、特征及解决方法。 欠拟合的 ...
2024-12-06在数据分析中,欠拟合和特征选择之间存在着紧密的联系。欠拟合指的是模型过于简单,无法有效捕捉数据中的复杂模式,导致在训练集和测试集上表现不佳。特征选择在解决欠拟合问题中扮演着至关重要的角色,帮助模型更好 ...
2024-12-06数据分析领域中,集成学习是一项关键技术,它通过结合多个模型的力量,提升整体预测性能和稳定性。这种方法利用多个个体学习器的智慧,以改善模型的准确度、泛化能力和鲁棒性。我们将深入探讨几种常见的集成学习方法 ...
2024-12-06当涉及使用SPSS进行假设检验时,步骤至关重要。这些步骤不仅需要逻辑连贯,而且在进行数据分析时也需要精确性和耐心。让我们一起深入探讨如何有效地运用SPSS进行假设检验,从建立假设到解读结果。 建立假设 首先,我 ...
2024-12-06Power BI(Business Intelligence)是一款功能强大的数据分析工具,能够帮助用户从各种数据源中提取信息、进行可视化并生成深入见解。无论您是数据分析新手还是经验丰富的专家,掌握如何在Power BI中创建报告与仪表 ...
2024-12-06卷积神经网络(CNN)和循环神经网络(RNN)是深度学习领域中两个重要而独特的神经网络架构。它们各自在处理不同类型的数据和任务时展现出独特优势,使得它们成为机器学习领域中的核心技术之一。让我们深入探讨它们的 ...
2024-12-06在数据仓库中,事实表和维度表的更新策略至关重要,以确保数据的一致性和准确性。本文将深入探讨事实表和维度表的更新策略,以及在不同情况下的最佳实践和应用。 事实表的数据更新策略 完整刷新 事实表可以通过完整 ...
2024-12-06数据分析模型的构建是一个错综复杂的过程,涉及数据处理、模型训练、误差分析和优化等多个关键环节。在这篇文章中,我们将深入探讨常见的问题及解决方案,以及如何通过错误分析不断完善模型。 数据问题 数据在数据分 ...
2024-12-06做数据聚合时,PySpark的groupBy()确实能完成统计,这也是它的本职工作。但它有一个根本性局限:每一组数据,最终只能返回一行 ...
2026-10-01热力地图是数据可视化中极具辨识度与实用性的空间分析图表,结合地理空间维度与数据密度特征,通过颜色深浅、色阶渐变直观展示数 ...
2026-09-30 很多数据分析师做过按月份的销售额趋势图,画过按天的流量折线图,但当被问到“时间序列和普通数据有什么本质区别”“季节性 ...
2026-09-30同样是“银行数据岗”,在国有大行总行数据中心、在一家城商行的零售部、在银行系金融科技子公司、在保险公司,工作内容、成长节 ...
2026-09-29在数据分析与统计学研究中,数据往往不是独立存在的,不同变量之间普遍存在相互关联、相互影响的关系。相关性统计分析是挖掘变量 ...
2026-09-29 导读:大多数人只把 dataclasses 当成偷懒工具,用来少写 __init__、__repr__ 这类魔法方法。但它的能力远不止于此。本文带 ...
2026-09-29 很多数据分析师能熟练地计算指标、搭建标签体系,但当被问到“画像到底在解决什么问题”“画像和标签是什么关系”“画像如何 ...
2026-09-29在MySQL数据库运维与业务开发中,行业普遍存在“数据达到千万级就必须分表”的说法。但在实际生产环境中,千万条数据并不是强制 ...
2026-09-28CDA数据分析师 出品 作者:李诗怡 1. 5W1H 分析法 定义:经典系统性思维框架,通过六个核心维度对问题进行全方位拆解与剖析,确 ...
2026-09-28 很多分析师在设计标签时思路清晰,但真到落地环节却面临“数据在手,不知如何转化为可用标签”的困境:或因加工方式选择不当 ...
2026-09-28CDA数据分析师 出品 作者:李诗怡 1. 用户标签体系 定义: 通过一系列高度精炼的特征标识,对用户属性、行为与偏好进行量化刻画 ...
2026-09-24Pandas是Python生态中用于表格数据处理的核心库,广泛应用于数据清洗、统计运算、报表输出、数据分析建模等场景。在处理极大数值 ...
2026-09-24随着数字经济快速发展,数据已成为核心生产要素,各行各业的业务沉淀、用户行为、设备运行、市场交易均产生海量数据。数据处理作 ...
2026-09-24 很多分析师每天和数据打交道,但当被问到“标签是什么”“标签和指标有什么区别”“标签体系如何设计”时,却常常答不上来。 ...
2026-09-24在时序数据分析中,大部分业务数据并非持续平稳变化,而是会在某些时间节点出现突然抬升、断崖下跌、趋势反转、波动异变等现象, ...
2026-09-23在统计学与数据分析中,研究多组数据差异最常用的方法为单因素方差分析与事后多重比较。很多数据分析初学者容易混淆两者功能,认 ...
2026-09-23 很多数据分析师每天都在写 SQL,但当被问到“DQL 的本质是什么”“SELECT 子句的书写顺序与执行顺序为何不同”“INNER JOIN ...
2026-09-23 很多数据分析师写过无数个SELECT查询,但当被问到“如何新建一张表来固化中间数据”“创建视图和创建物理表有什么区别”“视 ...
2026-09-22CDA数据分析师 出品 作者:李诗怡 1. 金字塔原理 定义: 一种“先总后分、先结论后原因”的思考和表达方式。顶层为核心观点,中 ...
2026-09-22数据收集是数据分析、数据挖掘与数字化运营的源头工作,数据收集的完整性、准确性、时效性直接决定后续数据分析结果的可信度与业 ...
2026-09-21


