图文讲解选择排序算法的原理及在Python中的实现
基本思想:从未排序的序列中找到一个最小的元素,放到第一位,再从剩余未排序的序列中找到最小的元素,放到第二位,依此类推,直到所有元素都已排序完毕。假设序列元素总共n+1个,则我们需要找n轮,就可以使该序列排好序。在每轮中,我们可以这样做:用未排序序列的第一个元素和后续的元素依次相比较,如果后续元素小,则后续元素和第一个元素交换位置放到,这样一轮后,排在第一位的一定是最小的。这样进行n轮,就可排序。
原理图
图1:
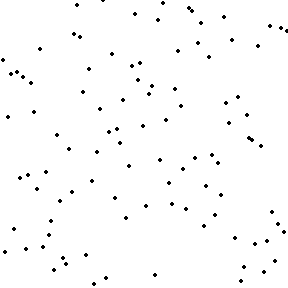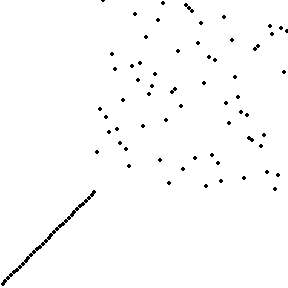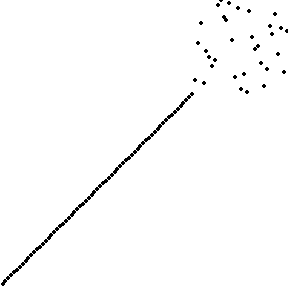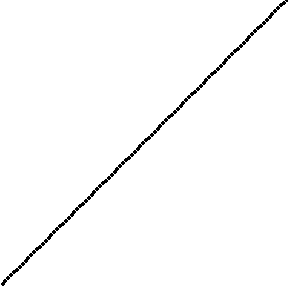
图2:
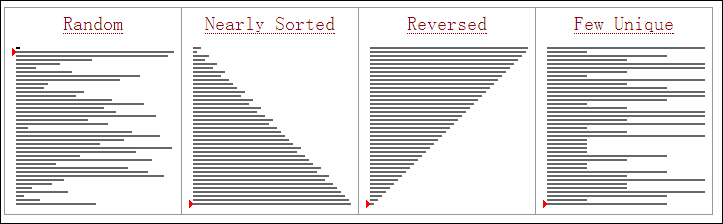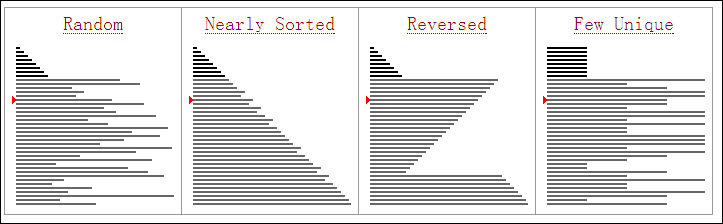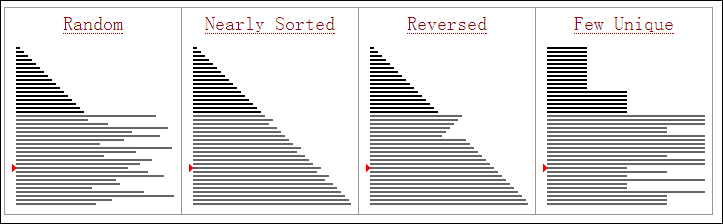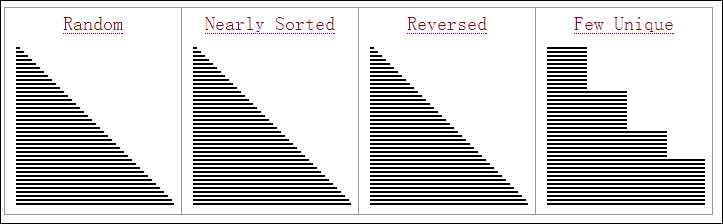
初始数据不敏感,不管初始的数据有没有排好序,都需要经历N2/2次比较,这对于一些原本排好序,或者近似排好序的序列来说并不具有优势。在最好的情况下,即所有的排好序,需要0次交换,最差的情况,倒序,需要N-1次交换。
数据交换的次数较少,如果某个元素位于正确的最终位置上,则它不会被移动。在最差情况下也只需要进行N-1次数据交换,在所有的完全依靠交换去移动元素的排序方法中,选择排序属于比较好的一种。
python代码实现:
def sort_choice(numbers, max_to_min=True):
"""
我这没有按照标准的选择排序,假设列表长度为n,思路如下:
1、获取最大值x,将x移动到列最后。[n1, n2, n3, ... nn]
2、将x追加到排序结果[n1, n3, ... nn, n2]
3、获取排序后n-1个元素[n1, n3, ... nn],重复第一步,重复n-1次。
max_to_min是指从大到小排序,默认为true;否则从小到大排序。
对[8, 4, 1, 0, 9]排序,大致流程如下:
sorted_numbers = []
[8, 4, 1, 0, 9], sorted_numbers = [9]
[4, 1, 0, 8], sorted_numbers = [9, 8]
[1, 0, 4], sorted_numbers = [9, 8, 4]
[0, 1], sorted_numbers = [9, 8, 4, 1]
[0], sorted_numbers = [9, 8, 4, 1, 0]
"""
if len(numbers) <= 1:
return numbers
sorted_list = []
index = 0
for i in xrange(len(numbers) - index):
left_numbers = _get_left_numbers(numbers, max_to_min)
numbers = left_numbers[:-1]
sorted_list.append(left_numbers[-1])
index += 1
return sorted_list
def _get_left_numbers(numbers, get_max=True):
'''
获取最大值或者最小值x,并且将x抽取出来,置于列表最后.
Ex: get_max=True, [1, 4, 3] ⇒ [1, 3, 4]
get_max=False, [1, 4, 3] ⇒ [4, 3 ,1]
'''
max_index = 0
for i, num in enumerate(numbers):
if get_max:
if num > numbers[max_index]:
max_index = i
else:
if num < numbers[max_index]:
max_index = i
numbers = numbers[:max_index] + numbers[max_index + 1:] + [numbers[max_index]]
return numbers
测试一下:
>>> get_left_numbers([0, 4, 0, 31, 9, 19, 89,67], get_max=True)
[0, 4, 0, 31, 9, 19, 67, 89]
>>> get_left_numbers([0, 4, 0, 31, 9, 19, 89,67], get_max=False)
[4, 0, 31, 9, 19, 89, 67, 0]
>>> sort_choice([0, 4, 0, 31, 9, 19, 89,67], max_to_min=False)
[0, 0, 4, 9, 19, 31, 67, 89]
>>> sort_choice([0, 4, 0, 31, 9, 19, 89,67], max_to_min=True)
[89, 67, 31, 19, 9, 4, 0, 0]


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330