用R语言进行关联分析
关联是两个或多个变量取值之间存在的一类重要的可被发现的某种规律性。关联分析目的是寻找给定数据记录集中数据项之间隐藏的关联关系,描述数据之间的密切度。
几个基本概念
1. 项集
这是一个集合的概念,在一篮子商品中的一件消费品即为一项(Item),则若干项的集合为项集,如{啤酒,尿布}构成一个二元项集。
2. 关联规则
一般记为的形式,X为先决条件,Y为相应的关联结果,用于表示数据内隐含的关联性。如:,表示购买了尿布的消费者往往也会购买啤酒。
关联性强度如何,由三个概念——支持度、置信度、提升度来控制和评价。
例:有10000个消费者购买了商品,其中购买尿布1000个,购买啤酒2000个,购买面包500个,同时购买尿布和面包800个,同时购买尿布和面包100个。
3. 支持度(Support)
支持度是指在所有项集中{X, Y}出现的可能性,即项集中同时含有X和Y的概率:
该指标作为建立强关联规则的第一个门槛,衡量了所考察关联规则在“量”上的多少。通过设定最小阈值(minsup),剔除“出镜率”较低的无意义规则,保留出现较为频繁的项集所隐含的规则。
设定最小阈值为5%,由于{尿布,啤酒}的支持度为800/10000=8%,满足基本输了要求,成为频繁项集,保留规则;而{尿布,面包}的支持度为100/10000=1%,被剔除。
4. 置信度(Confidence)
置信度表示在先决条件X发生的条件下,关联结果Y发生的概率:
这是生成强关联规则的第二个门槛,衡量了所考察的关联规则在“质”上的可靠性。相似的,我们需要对置信度设定最小阈值(mincon)来实现进一步筛选。
具体的,当设定置信度的最小阈值为70%时,置信度为800/1000=80%,而的置信度为800/2000=40%,被剔除。
5. 提升度(lift)
提升度表示在含有X的条件下同时含有Y的可能性与没有X这个条件下项集中含有Y的可能性之比:
该指标与置信度同样衡量规则的可靠性,可以看作是置信度的一种互补指标。
R中Apriori算法
算法步骤:
1. 选出满足支持度最小阈值的所有项集,即频繁项集;
2. 从频繁项集中找出满足最小置信度的所有规则。
> library(arules) #加载arules包
> click_detail =read.transactions("click_detail.txt",format="basket",sep=",",cols=c(1)) #读取txt文档(文档编码为ANSI)
> rules <- apriori(click_detail, parameter =list(supp=0.01,conf=0.5,target="rules")) #调用apriori算法
> rules
set of419 rules
> inspect(rules[1:10]) #查看前十条规则
解释
1) library(arules):加载程序包arules,当然如果你前面没有下载过这个包,就要先install.packages(arules)
2) click_detail =read.transactions("click_detail.txt",format="basket",sep=",",cols=c(1)):读入数据
read.transactions(file, format =c("basket", "single"), sep = NULL,
cols = NULL, rm.duplicates =FALSE, encoding = "unknown")
file:文件名,对应click_detail中的“click_detail.txt”
format:文件格式,可以有两种,分别为“basket”,“single”,click_detail.txt中用的是basket。
basket: basket就是篮子,一个顾客买的东西都放到同一个篮子,所有顾客的transactions就是一个个篮子的组合结果。如下形式,每条交易都是独立的。
文件形式:
item1,item2
item1
item2,item3
读入后:
items
1 {item1,
item2}
2 {item1}
3 {item2,
item3}
single: single的意思,顾名思义,就是单独的交易,简单说,交易记录为:顾客1买了产品1, 顾客1买了产品2,顾客2买了产品3……(产品1,产品2,产品3中可以是单个产品,也可以是多个产品),如下形式:
trans1 item1
trans2 item1
trans2 item2
读入后:
items transactionID
1 {item1} trans1
2 {item1,
item2} trans2
sep:文件中数据是怎么被分隔的,默认为空格,click_detail里面用逗号分隔
cols:对basket, col=1,表示第一列是数据的transaction ids(交易号),如果col=NULL,则表示数据里面没有交易号这一列;对single,col=c(1,2)表示第一列是transaction
ids,第二列是item ids
rm.duplicates:是否移除重复项,默认为FALSE
encoding:写到这里研究了encoding是什么意思,发现前面txt可以不是”ANSI”类型,如果TXT是“UTF-8”,写encoding=”UTF-8”,就OK了.
3) rules <- apriori(click_detail,parameter = list(supp=0.01,conf=0.5,target="rules")):apriori函数
apriori(data, parameter = NULL, appearance = NULL, control = NULL)
data:数据
parameter:设置参数,默认情况下parameter=list(supp=0.1,conf=0.8,maxlen=10,minlen=1,target=”rules”)
supp:支持度(support)
conf:置信度(confidence)
maxlen,minlen:每个项集所含项数的最大最小值
target:“rules”或“frequent itemsets”(输出关联规则/频繁项集)
apperence:对先决条件X(lhs),关联结果Y(rhs)中具体包含哪些项进行限制,如:设置lhs=beer,将仅输出lhs含有beer这一项的关联规则。默认情况下,所有项都将无限制出现。
control:控制函数性能,如可以设定对项集进行升序sort=1或降序sort=-1排序,是否向使用者报告进程(verbose=F/T)
补充
通过支持度控制:rules.sorted_sup = sort(rules, by=”support”)
通过置信度控制:rules.sorted_con = sort(rules, by=”confidence”)
通过提升度控制:rules.sorted_lift = sort(rules, by=”lift”)
Apriori算法
两步法:
1. 频繁项集的产生:找出所有满足最小支持度阈值的项集,称为频繁项集;
2. 规则的产生:对于每一个频繁项集l,找出其中所有的非空子集;然后,对于每一个这样的子集a,如果support(l)与support(a)的比值大于最小可信度,则存在规则a==>(l-a)。
频繁项集产生所需要的计算开销远大于规则产生所需的计算开销
频繁项集的产生
几个概念:
1, 一个包含K个项的数据集,可能产生2^k个候选集
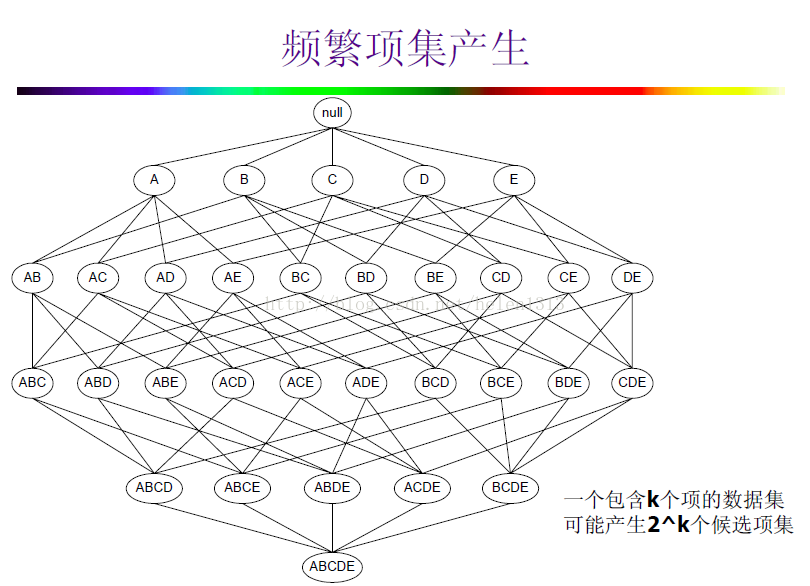
2,先验原理:如果一个项集是频繁的,则它的所有子集也是频繁的(理解了频繁项集的意义,这句话很容易理解的);相反,如果一个项集是非频繁的,则它所有子集也一定是非频繁的。
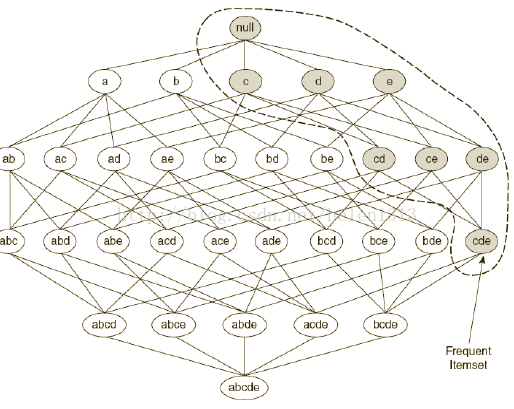
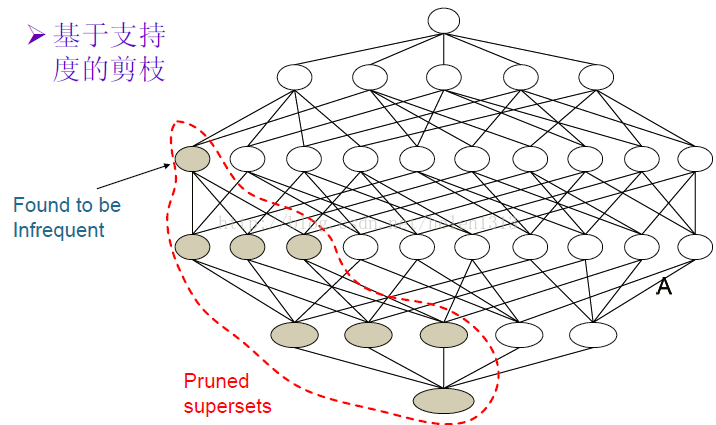
3基于支持度(SUPPORT)度量的一个关键性质:一个项集的支持度不会超过它的子集的支持度(很好理解,支持度是共同发生的概率,假设项集{A,B,C},{A,B}是它的一个自己,A,B,C同时发生的概率肯定不会超过A,B同时发生的概率)。
上面这条规则就是Apriori中使用到的,如下图,当寻找频繁项集时,从上往下扫描,当遇到一个项集是非频繁项集(该项集支持度小于Minsup),那么它下面的项集肯定就是非频繁项集,这一部分就剪枝掉了。
一个例子(百度到的一个PPT上的):
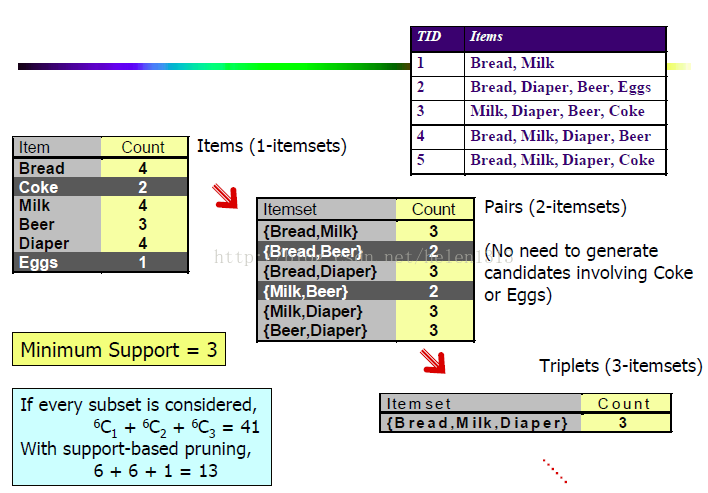
当我在理解频繁项集的意义时,在R上简单的复现了这个例子,这里采用了eclat算法,跟apriori应该差不多:
代码:
item <- list(
c("bread","milk"),
c("bread","diaper","beer","eggs"),
c("milk","diaper","beer","coke"),
c("bread","milk","diaper","beer"),
c("bread","milk","diaper","coke")
)
names(item) <- paste("tr",c(1:5),sep = "")
item
trans <- as(item,"transactions") #将List转为transactions型
rules = eclat(trans,parameter = list(supp = 0.6,
target ="frequent itemsets"),control = list(sort=1))
inspect(rules) #查看频繁项集
运行后结果:
>inspect(rules)
items support
1{beer,
diaper} 0.6
2{diaper,
milk} 0.6
3{bread,
diaper} 0.6
4{bread,
milk} 0.6
5{beer} 0.6
6{milk} 0.8
7{bread} 0.8
8{diaper} 0.8
以上就是该例子的所有频繁项集,然后我发现少了{bread,milk,diaper}这个项集,回到例子一看,这个项集实际上只出现了两次,所以是没有这个项集的。
规则的产生
每个频繁k项集能产生最多2k-2个关联规则
将项集Y划分成两个非空的子集X和Y-X,使得X ->Y-X满足置信度阈值
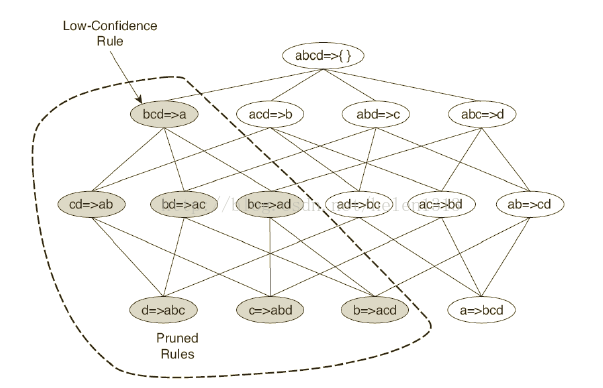
定理:如果规则X->Y-X不满足置信度阈值,则X’->Y-X’的规则一定也不满足置信度阈值,其中X’是X的子集
Apriori按下图进行逐层计算,当发现一个不满足置信度的项集后,该项集所有子集的规则都可以剪枝掉了。


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330