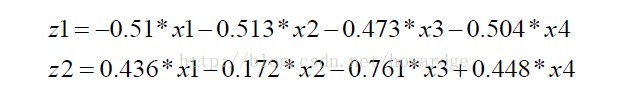京公网安备 11010802034615号
经营许可证编号:京B2-20210330
R语言与数据分析:主成分分析
作为数据分析师,有很多刚刚接触数据分析师的朋友,还不怎么了解主成分分析,看看这两篇,你就搞懂主成分分析了。
第一篇:主成份分析历史
Pearson于1901年提出,再由Hotelling(1933)加以发展的一种多变量统计方法。通过析取主成分显出最大的个别差异,也用来削减回归分析和聚类分析中变量的数目,可以使用样本协方差矩阵或相关系数矩阵作为出发点进行分析。
通过对原始变量进行线性组合,得到优化的指标:把原先多个指标的计算降维为少量几个经过优化指标的计算(占去绝大部分份额)
基本思想:设法将原先众多具有一定相关性的指标,重新组合为一组新的互相独立的综合指标,并代替原先的指标。
成分的保留:Kaiser主张(1960)将特征值小于1的成分放弃,只保留特征值大于1的成分。
接下来以小学生基本生理属性为案例分享下R语言的具体实现,分别选取身高(x1)、体重(x2)、胸围(x3)和坐高(x4)。具体如下:
student<- data.frame( x1=c(148,139,160,149,159,142,153,150,151), x2=c(41 ,34 , 49 ,36 ,45 ,31 ,43 ,43,
42), x3=c(72 ,71 , 77 ,67 ,80 ,66 ,76 ,77,77), x4=c(78 ,76 , 86 ,79 ,86 ,76 ,83 ,79 ,80)
) student.pr <- princomp(student,cor=TRUE) summary(student.pr,loadings=TRUE) screeplot(student.pr,type="
lines")
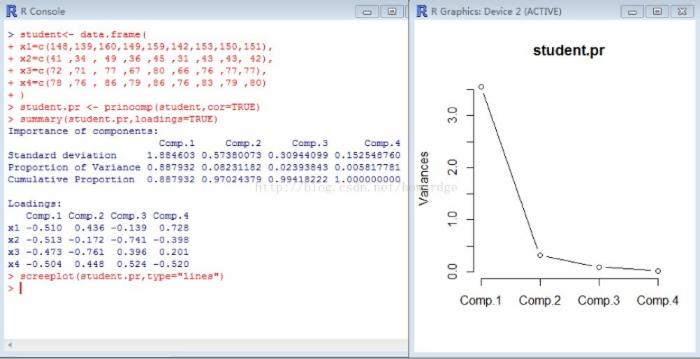
结果如截图:
由上图可见四项指标做分析后,给出了4个成分,他们的重要性分别为:0.887932、0.08231182、0.02393843、0.005817781,累积贡献为:0.887932、0.97024379、
0.99418222 1.000000000各个成分的碎石图也如上,可见成份1和成份2的累积贡献已经达到95%,因此采用这两个成份便可充分解释学生的基本信息。
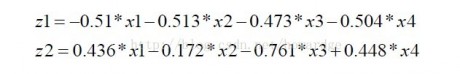
我们可以通过R自动算出各主成份的值,并画出散点图:
temp<-predict(student.pr)
plot(temp[,1:2])
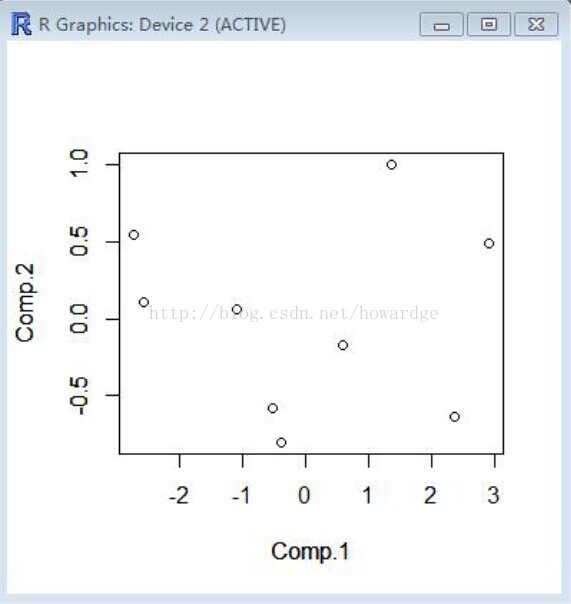
结果如图:
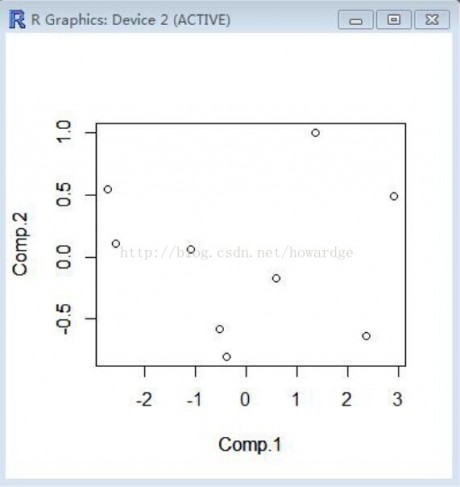
观察如图可见两个成分的分离度很高,比较理想。
第二篇: 主成分分析(principal component analysis,PCA)是一种降维技术,把多个变量化为能够反映原始变量大部分信息的少数几个主成分。
设X有p个变量,为n*p阶矩阵,即n个样本的p维向量。首先"数据分析师"对X的p个变量寻找正规化线性组合,使它的方差达到最大,这个新的变量称为第一主成分,抽取第一主成分后,第二主成分的抽取方法与第一主成分一样,依次类推,直到各主成分累积方差达到总方差的一定比例。
主成分分析的计算步骤:
假设样本观测数据矩阵为:
X=(x1,x2,x3,…xp),xi为n个样本在第i个属性上的观测值,是一个列向量
1.对原始数据标准化处理(0均值化处理)
2.计算样本相关系数矩阵
3.计算协方差矩阵的特征值和特征向量
4、选择重要的主成分,并写出主成分表达式
5.计算主成分得分
6.根据主成分得分的数据,做进一步的统计分析。
主成分分析可以得到p个主成分,但是,由于各个主成分的方差是递减的,包含的信息量也是递减的,所以实际分析时,一般不是选取p个主成分,而是根据各个主成分累计贡献率的大小选取前k个主成分,这里贡献率就是指某个主成分的方差占全部方差的比重,实际也就是某个特征值占全部特征值总和的比重。贡献率越大,说明该主成分所包含的原始变量的信息越强。主成分个数k的选取,主要根据主成分的累积贡献率来决定,即一般要求累计贡献率达到85%以上,这样才能保证综合变量能包括原始变量的绝大多数信息。
另外,数据分析师在实际应用中,选择了重要的主成分后,还要注意主成分实际含义解释。主成分分析中一个很关键的问题是如何给主成分赋予新的意义,给出合理的解释。一般而言,这个解释"数据分析师"是根据主成分表达式的系数结合定性分析来进行的。主成分是原来变量的线性组合,在这个线性组合中个变量的系数有大有小,有正有负,有的大小相当,因而不能简单地认为这个主成分是某个原变量的属性的作用,线性组合中各变量系数的绝对值大者表明该主成分主要综合了绝对值大的变量,有几个变量系数大小相当时,应认为这一主成分是这几个变量的总和,这几个变量综合在一起应赋予怎样的实际意义,这要结合具体实际问题和专业,给出恰当的解释,进而才能达到深刻分析的目的 。
在R里手工统计过程如下:
> #数据集
> y=USArrests
> #相关矩阵
> c=cor(y)
> #特征值
> e=eigen(c)
> e
$values #特征值
[1] 2.4802416 0.9897652 0.3565632 0.1734301
$vectors 特征向量,也就是主成分的表达式
[,1] [,2] [,3] [,4]
[1,] -0.5358995 0.4181809 -0.3412327 0.64922780
[2,] -0.5831836 0.1879856 -0.2681484 -0.74340748
[3,] -0.2781909 -0.8728062 -0.3780158 0.13387773
[4,] -0.5434321 -0.1673186 0.8177779 0.08902432
> # 计算标准化的主成分得分
> scale( as.matrix(y))%*%e$vector
[,1] [,2] [,3] [,4]
Alabama -0.97566045 1.12200121 -0.43980366 0.154696581
Alaska -1.93053788 1.06242692 2.01950027 -0.434175454
Arizona -1.74544285 -0.73845954 0.05423025 -0.826264240
Arkansas 0.13999894 1.10854226 0.11342217 -0.180973554
…..
West Virginia 2.08739306 1.41052627 0.10372163 0.130583080
Wisconsin 2.05881199 -0.60512507 -0.13746933 0.182253407
Wyoming 0.62310061 0.31778662 -0.23824049 -0.164976866
R中下面两个函数可以用做主成分分析
princomp(x, cor = FALSE, scores = TRUE, covmat = NULL,
subset = rep(TRUE, nrow(as.matrix(x))), …)
cor =TRUE 是使用相关矩阵求主成分,否则使用协方差矩阵。
prcomp(x, retx = TRUE, center = TRUE, scale. = FALSE,
tol = NULL, …)
scale =TRUE 即使用相关矩阵求主成分夬否则使用协方差矩阵
求主成分。
> # prcomp() 的用法
> p=prcomp(USArrests, scale=T)
> p
Standard deviations:
[1] 1.5748783 0.9948694 0.5971291 0.4164494
Rotation:
PC1 PC2 PC3 PC4
Murder -0.5358995 0.4181809 -0.3412327 0.64922780
Assault -0.5831836 0.1879856 -0.2681484 -0.74340748
UrbanPop -0.2781909 -0.8728062 -0.3780158 0.13387773
Rape -0.5434321 -0.1673186 0.8177779 0.08902432
> summary(p)
Importance of components:
PC1 PC2 PC3 PC4
Standard deviation 1.5749 0.9949 0.59713 0.41645
Proportion of Variance 0.6201 0.2474 0.08914 0.04336
Cumulative Proportion 0.6201 0.8675 0.95664 1.00000
#计算标准化的主成分得分
> predict(p)cda数据分析师培训
结果和手工统计的一样。
数据分析咨询请扫描二维码
若不方便扫码,搜微信号:CDAshujufenxi
一、问题:为什么 ID 会"断号" 很多刚接触 MySQL 的同学都会有一个困惑:表里的主键 ID 是自增的,删了中间几行数据之后,ID 变 ...
2026-10-22一、问题场景:为什么会重复 JOIN 同一个子查询 在写复杂 SQL 时,经常遇到这种需求:同一张表或同一个聚合子查询,要和主表关联 ...
2026-10-22人力资源专员是HR体系的执行入口。招聘信息发布、简历初筛、面试安排、考勤汇总、入离职手续、劳动合同与档案管理,大多由这个岗 ...
2026-10-22人力资源经理问“必学技巧”,真正要解决的不是知识清单不够长,而是时间有限、业务催得紧,学完却用不上。更有效的路径是:先用 ...
2026-10-22内容营销岗位的核心任务,不是“把文案写得更漂亮”,而是围绕目标受众,用持续的内容供给影响认知、推动转化并沉淀复购。它至少 ...
2026-10-22理财经理培训课程很多,难的是判断“先学什么、后学什么、学完能做什么”。与其按课程名称罗列,不如先看岗位任务:客户分层与维 ...
2026-10-22理财经理的知识结构,可以先用一句话概括:合规与产品知识决定“不出错”,客户经营与资产配置决定“够不够专业”,市场研判与数 ...
2026-10-22经济学背景做数据分析,优势不在工具,而在问题意识:供需如何相互作用、成本与收益如何权衡、变量之间是相关还是因果。真正的缺 ...
2026-10-22需要,但要把“需要”理解准确。经济学本身就在处理数据:GDP、物价、就业、企业营收、问卷调研,都是经济分析的原料。真正的区 ...
2026-10-22经济学分析能力不是单一技能,它至少由三层构成:把现实问题转成可检验假设的理论框架能力、用数据与统计方法验证假设的工具能力 ...
2026-10-22金融分析师的知识提升,先补的不是更多模型,而是让结论可复核的底层能力。按任务顺序,大致是四层:财务与业务理解、指标口径管 ...
2026-10-22金融分析师的“通用技能”,指换到不同机构、不同行业组仍用得上的底层能力,而非某家公司内部系统的操作经验。按任务拆,日常要 ...
2026-10-22先给结论:数据分析证书不是金融分析师的准入条件,招聘方也不会因为一张证书就直接判断你能做分析。要不要考,取决于你当前任务 ...
2026-10-22金融分析师的核心技能,不是“会看K线”或“会讲宏观”,而是能把一家公司、一个行业或一类资产,转化为可核查的数据判断与书面 ...
2026-10-22产品经理的知识提升,不是把需求文档、原型、SQL、数据分析、项目管理都学一遍,而是先对准目标岗位的真实任务,找出自己最缺的 ...
2026-10-22产品专员提升工作知识,最有效的方式不是先囤课程,而是围绕日常交付的四件事来补:需求调研与优先级判断、原型与PRD表达、竞品 ...
2026-10-22产品运营专员提升个人能力,常见误区是先把Excel、SQL、Python列成一张学习清单,然后从第一个工具开始学。更有效的做法是先回答 ...
2026-10-22产品运营的能力提升,最怕从“课程目录”出发:今天学增长模型,明天背SQL语法,学完却说不清自己负责的功能为什么激活率低。更 ...
2026-10-22产品经理的技能和影响力不是两条分开的赛道。技能决定你能不能把问题分析清楚、把方案设计对;影响力决定你的判断能否被团队接受 ...
2026-10-22产品经理要学的数据分析能力,不是“会写SQL”或“会用BI工具”这么简单。更准确地说,是围绕需求评估、功能迭代、指标监控、实 ...
2026-10-22