来源 | 脚本之家
在数据分析领域,最热门的莫过于Python和R语言,此前有一篇文章《别老扯什么Hadoop了,你的数据根本不够大》指出:只有在超过5TB数据量的规模下,Hadoop才是一个合理的技术选择。这次拿到近亿条日志数据,千万级数据已经是关系型数据库的查询分析瓶颈,之前使用过Hadoop对大量文本进行分类,这次决定采用Python来处理数据:
硬件环境
CPU:3.5 GHz Intel Core i7
内存:32 GB HDDR 3 1600 MHz
硬盘:3 TB Fusion Drive
数据分析工具
Python:2.7.6
Pandas:0.15.0
IPython notebook:2.0.0
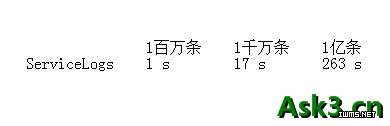
源数据如下表所示:
数据读取
启动IPython notebook,加载pylab环境:
ipython notebook --pylab=inline
Pandas提供了IO工具可以将大文件分块读取,测试了一下性能,完整加载9800万条数据也只需要263秒左右,还是相当不错了。
import pandas as pd
reader = pd.read_csv('data/servicelogs', iterator=True)
try:
df = reader.get_chunk(100000000)
except StopIteration:
print "Iteration is stopped."
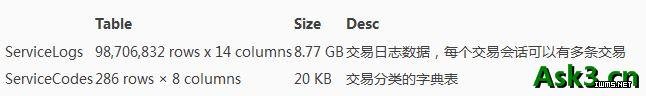
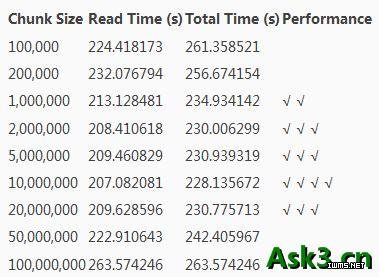
使用不同分块大小来读取再调用 pandas.concat 连接DataFrame,chunkSize设置在1000万条左右速度优化比较明显
loop = True
chunkSize = 100000
chunks = []
while loop:
try:
chunk = reader.get_chunk(chunkSize)
chunks.append(chunk)
except StopIteration:
loop = False
print "Iteration is stopped."
df = pd.concat(chunks, ignore_index=True)
下面是统计数据,Read Time是数据读取时间,Total Time是读取和Pandas进行concat操作的时间,根据数据总量来看,对5~50个DataFrame对象进行合并,性能表现比较好。

如果使用Spark提供的Python Shell,同样编写Pandas加载数据,时间会短25秒左右,看来Spark对Python的内存使用都有优化。
数据清洗
Pandas提供了 DataFrame.describe 方法查看数据摘要,包括数据查看(默认共输出首尾60行数据)和行列统计。由于源数据通常包含一些空值甚至空列,会影响数据分析的时间和效率,在预览了数据摘要后,需要对这些无效数据进行处理。
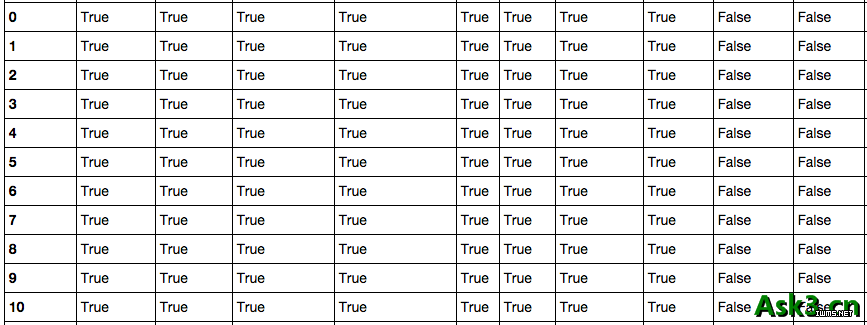
首先调用 DataFrame.isnull() 方法查看数据表中哪些为空值,与它相反的方法是 DataFrame.notnull() ,Pandas会将表中所有数据进行null计算,以True/False作为结果进行填充,如下图所示:
Pandas的非空计算速度很快,9800万数据也只需要28.7秒。得到初步信息之后,可以对表中空列进行移除操作。尝试了按列名依次计算获取非 空列,和 DataFrame.dropna() 两种方式,时间分别为367.0秒和345.3秒,但检查时发现 dropna() 之后所有的行都没有了,查了Pandas手册,原来不加参数的情况下, dropna() 会移除所有包含空值的行。如果只想移除全部为空值的列,需要加上 axis 和 how 两个参数:
df.dropna(axis=1, how='all')
共移除了14列中的6列,时间也只消耗了85.9秒。
接下来是处理剩余行中的空值,经过测试,在 DataFrame.replace() 中使用空字符串,要比默认的空值NaN节省一些空间;但对整个CSV文件来说,空列只是多存了一个“,”,所以移除的9800万 x 6列也只省下了200M的空间。进一步的数据清洗还是在移除无用数据和合并上。
对数据列的丢弃,除无效值和需求规定之外,一些表自身的冗余列也需要在这个环节清理,比如说表中的流水号是某两个字段拼接、类型描述等,通过对这些数据的丢弃,新的数据文件大小为4.73GB,足足减少了4.04G!
数据处理
使用 DataFrame.dtypes 可以查看每列的数据类型,Pandas默认可以读出int和float64,其它的都处理为object,需要转换格式的一般为日期时间。 DataFrame.astype() 方法可对整个DataFrame或某一列进行数据格式转换,支持Python和NumPy的数据类型。
df['Name'] = df['Name'].astype(np.datetime64
对数据聚合,我测试了 DataFrame.groupby 和 DataFrame.pivot_table 以及 pandas.merge ,groupby 9800万行 x 3列的时间为99秒,连接表为26秒,生成透视表的速度更快,仅需5秒。
df.groupby(['NO','TIME','SVID']).count() # 分组
fullData = pd.merge(df, trancodeData)[['NO','SVID','TIME','CLASS','TYPE']] # 连接
actions = fullData.pivot_table('SVID', columns='TYPE', aggfunc='count') # 透视表
根据透视表生成的交易/查询比例饼图:

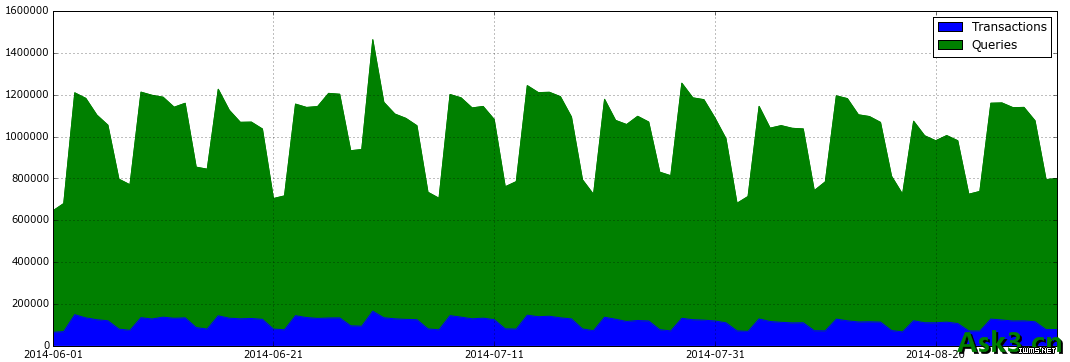
将日志时间加入透视表并输出每天的交易/查询比例图:
total_actions = fullData.pivot_table('SVID', index='TIME', columns='TYPE', aggfunc='count')
total_actions.plot(subplots=False, figsize=(18,6), kind='area')
除此之外,Pandas提供的DataFrame查询统计功能速度表现也非常优秀,7秒以内就可以查询生成所有类型为交易的数据子表:
tranData = fullData[fullData['Type'] == 'Transaction']
该子表的大小为 [10250666 rows x 5 columns]。在此已经完成了数据处理的一些基本场景。实验结果足以说明,在非“>5TB”数据的情况下,Python的表现已经能让擅长使用统计分析语言的数据分析师游刃有余。


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330