数据科学目标、挑战以及门派
随着云计算和人工智能的发展,数据科学这门新的综合学科被越来越多的人所熟知,业界也普遍看好其在未来的发展前景。体现在就业市场上,与这个行业相关的数据科学家和数据工程师成为了“21世纪最吸引人的职业”。
就像“一千个人眼里有一千个哈姆雷特”一样,对于什么是数据科学也有很多种不同的解读,并由此衍生出很多相关概念,比如数据驱动(data
driven)、大数据(big data)、分布式计算(distributed
computing)等。但这些概念都没能全面地描述数据科学的内涵,本文将从目标、挑战和门派三个方面来阐述什么是数据科学。
一、目标
数据科学是一门最近大火的新兴学科。这门学科的目标十分简单,就是如何从实际的生活中提取出数据,然后利用计算机的运算能力和模型算法从这些数据中找出一些有价值的内容,为商业决策提供支持。
传统的数据分析手段是所谓的商业智能(business
intelligence)。这种方法通常将数据按不同的维度交叉分组,并在此基础上,利用统计方法分析每个组别里的信息。比如商业智能中最常见的问题是:“过去3个月,通过搜索引擎进入网站并成功完成注册的新用户里,年龄分布情况如何?若将上面的用户群按年龄段分组,各组中有多大比例的用户在完成注册后,完成了至少一次消费?”
这样的分析是非常有用的,能揭示一些数据的直观信息。但这样的方法如同盲人摸象,只能告诉我们数据在某个局部的情况,而不能给出数据的全貌。而且对于某些问题,这样的结果显得有些不够用。比如用户注册之后完成消费的比例与哪些因素相关?又比如对于某个客户,他对某一产品的估计是多少?在这些场景下,我们就需要更加精细的数据分析工具—机器学习和统计模型。这些内容正是数据科学的核心内容。
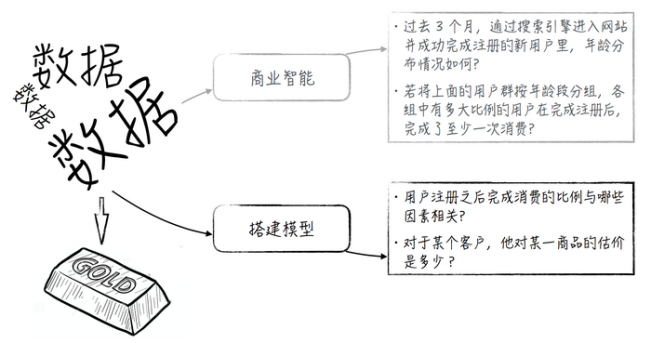
图1
二、挑战
在数据科学实践中,我们将使用较为复杂的机器学习或统计模型对数据做精细化的分析和预测。这在工程实现和模型搭建两方面都提出了挑战,如图2所示。
工程实现的挑战
数据科学在工程上的挑战可以大致分为3类:特征提取、矩阵运算和分布式机器学习。
(1)一个建模项目的成功在很大程度上依赖于建模前期的特征提取。它包含数据清洗、数据整合、变量归一化等。经过处理后,原本搅作一团的原始数据将被转换为能被模型使用的特征。这些工作需要大量的自动化程序来处理,特别是面对大数据时,因为这些大数据无法靠“人眼”来检查。在一个典型的建模项目中,这部分花费的时间远远大于选择和编写模型算法的时间。
(2)对于一个复杂的数学模型,计算机通常需要使用类似随机梯度下降法的最优化算法来估算它的模型参数。这个过程需要大量的循环,才能使参数到达收敛值附近。因此即使面对的是很小的数据集,复杂的模型也需要很长时间才能得到正确的参数估计。而且模型在结构上越复杂,需要估计的参数也就越多。对这些大量的模型参数同时做更新,在数学上对应着矩阵运算。但传统的CPU架构并不擅长做这样的运算,这导致模型训练需要耗费大量的时间。为了提高模型的训练速度,需要将相应的矩阵运算(模型参数的估算过程)移植到GPU或者特制的计算芯片上,比如TPU。
(3)近年来,随着分布式系统的流行和普及,存储海量数据成为了业界的标配。为了能在这海量的数据上使用复杂模型,需要将原本在一台机器上运行的模型算法改写成能在多台机器上并行运行,这也是分布式机器学习的核心内容。
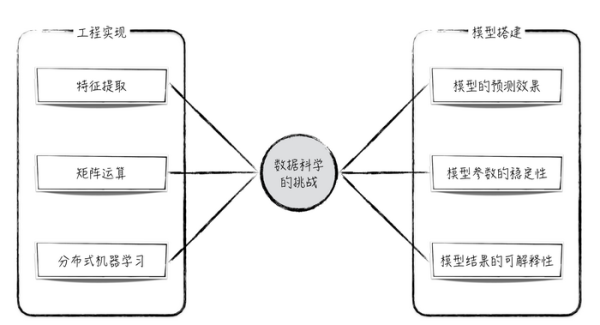
图2
模型搭建的挑战
数据科学对模型搭建的要求也可以总结为3点:模型预测效果好、模型参数是稳定且“正确”的、模型结果容易解释。
(1)模型的预测效果好,这是数据科学成功的关键。而一个模型的预测效果取决于它的假设是否被满足。从数学上来看,任何一个模型除去假设部分,它的其他推导都是严谨的数学演算,是无懈可击的。因此模型假设就像模型的阿喀琉斯之踵,是它唯一的薄弱环节。当问题场景或数据满足模型假设时,模型的效果一定不会差,反之,则预测效果就无法保证了。但在实际生产中,针对一个具体的问题,几乎不可能找到一个模型,它的假设被百分之百地满足。这时就需要避重就轻,通过特征提取等手段,尽量避免违反那些对结果影响很大的假设。这就是为什么说“所有模型都是错的,但是,其中有一些是有用的”。
(2)除了被用来对未知数据做预测外,模型另一个重要的功能就是对已有数据做分析,比如哪个变量对结果的影响最大或者某个变量对结果到底是正向影响还是负向影响等。这些分析结果在很大程度上依赖于模型参数的估计值,后者的准确与否直接决定分析结果的质量。但问题是,模型参数的估计值是不太“可靠”的。例如从训练数据中随机抽取两个不完全一样的数据子集A和B,然后用这两个数据集分别训练同一个模型。得到的参数估计值几乎不可能完全一样。从数学的角度来看,这说明模型参数的估计值其实是一个随机变量,具体的值取决于训练模型时使用的数据。于是我们要求这些估计值是“正确”的:围绕参数真实值上下波动(也就是说它们的期望等于参数真实值)。我们还要求这些估计值是稳定的:波动的幅度不能太大(也就是说它们的方法比较小)。这样就可以把参数估计值的“不可靠性”控制在可接受的范围内。
(3)数据科学家将模型搭建好,并不是一个数据科学项目的终点。为了充分发挥数据的价值,需要将模型结果应用到实际的生产中,比如为手机银行APP架设实时反欺诈系统,或者将利用新搭建的车祸风险模型为汽车保险定价等。参与这个过程的不仅有懂模型的数据科学家,还有更多非技术的业务人员。而后者往往是使用模型的主力,比如根据反欺诈系统的结果,对可疑用户进行人工审核,又或者向客户解释为什么他的车险比别人贵。为了帮助他们更好地理解模型结果,需要将复杂深奥的模型翻译成直观的普通语言。这要求模型是能被解释的,而且是容易被解释的。
三、两大门派
和武侠世界里有少林和武当两大门派一样,数据科学领域也有两个不同的学派:以统计分析为基础的统计学派,以及以机器学习为基础的人工智能派。虽然这两个学派的目的都是从数据中挖掘价值,但彼此“都不服气”。注重模型预测效果的人工智能派认为统计学派“固步自封”,研究和使用的模型都只是一些线性模型,太过简单,根本无法处理复杂的现实数据。而注重假设和模型解释的统计学派则认为人工智能派搭建的模型缺乏理论依据、无法解释,很难帮助我们通过模型去理解数据。
在学术上,通常将统计学派的模型称为数据模型(data model),将人工智能派的模型称为算法模型(algorithm model),如图3所示。
数据模型的建模思路是假设数据的产生过程是已知的(或者是可以假设的),可以通过模型去理解整个过程。因此,这类模型通常具有很好的可解释性,分析其稳定性的数学工具也很多,能很好地满足上面提到的后两点。但是在实际生产中,这些模型的预测效果并不好,或者更准确地说,单独使用时,预测效果并不理想。
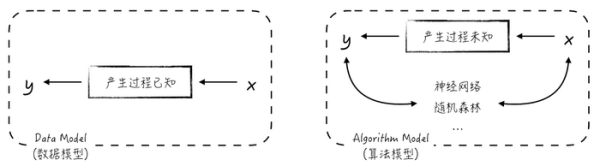
图3
上图算法模型,也就是人工智能的核心内容,它们假设数据的产生过程是复杂且未知的。建模的目的是尽可能地从结构上“模仿”数据的产生过程,从而达到较好的预测效果。但代价是模型的可解释性很差,而且模型稳定性的分析方法也不多。
事实上,统计学和机器学习在某些方面具有极好的互补性。因此在实际的生产中,为了将一个数据科学项目做得尽可能完美,我们需要将这两种思路结合起来使用。比如使用机器学习的模型对数据建模,然后借鉴数据模型的分析工具,分析模型的稳定性和给出模型结果的直观解释。
四、模型幻觉
虽然数据科学领域两大门派的模型很多,但它们都特别依赖所使用的数据。但是数据就百分之百可靠吗?下面就来看两个数据“说谎”的例子。
如图4所示,我们将某APP每月的用户注册数表示在图中。图4a给人的直观印象是每月的安装数是大致差不多的,没有明显的增长。而图4b给人不同的印象,从3月份开始,用户注册数大幅度增长。但其实两幅图的数据是一模一样的,给人不同的感觉是因为图4a中纵轴的起点是0,而且使用了对数尺度;而图4b的纵轴是从17
000开始的,而且使用的是线性尺度。
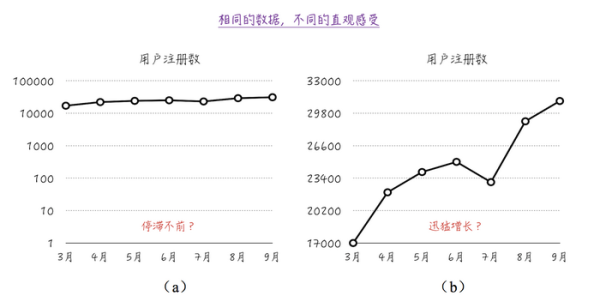
图4
读者可能会觉得上面这个例子太过简单了,只需要使用一些简单的统计指标,比如平均值或每个月的增长率,就可以避免错误的结论。那么下面来看一个复杂一点的例子。
当得到如图所示的两组数据时,我们应该如何用模型去描述数据的变化规律呢?
对于图5a,数据的图形有点像抛物线,因此选择二次多项式拟合是一个比较合理的选择。于是假设模型的形式为y = (x - a)(x - b)。然后使用数据去估计模型中的未知参数a, b。得到的结果还不错,模型的预测值与真实值的差异并不大。
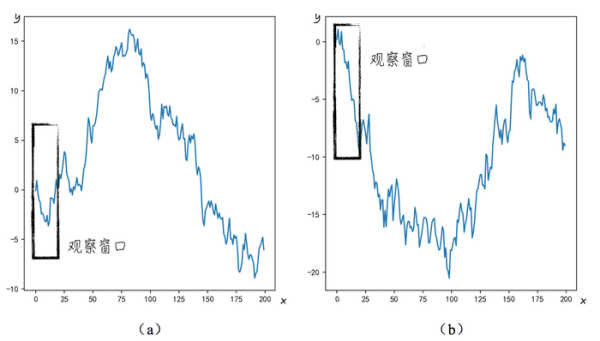
图5
对于图5b,数据之间有明显的线性关系,所以使用线性回归对其建模,即y = ax + b。与上面类似,得到的模型结果也不错。
根据上面的分析结果,可以得出如下的结论,图5a中的x与y之间是二次函数关系,而图5b的x与y之间是线性关系。但其实两幅图中的变量y都是与x无关的随机变量,只是因为观察窗口较小,收集的数据样本太少,让我们误以为它们之间存在某种关系。如果增大观察窗口,收集更多的数据,则可以得到完全不同的结论。如图6所示,如果将收集的样本数从20增加到200,会发现图6a中的数据图形更像是一个向下开口的抛物线,这与图5a中的结论完全相反。而图6b中也不再是向下的直线,而与开口向上的抛物线更加相似。
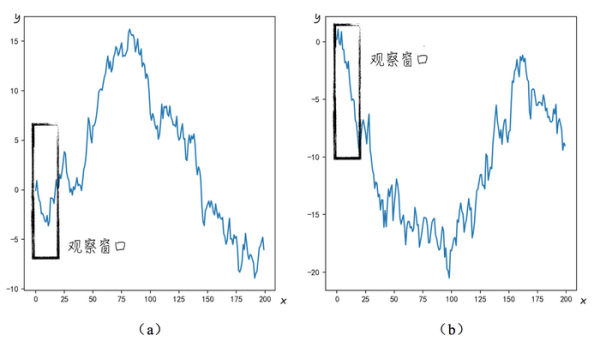
图6
图6上面的例子就是所谓的模型幻觉:表面上找到了数据变动的规律,但其实只是由随机扰动引起的数字巧合。因此在对搭建模型时,必须时刻保持警惕,不然很容易掉进数据的“陷阱”里,被数据给骗了,而这正是数据科学的研究重点。这门学科会“小心翼翼”地处理它的各种模型,以确保模型能摆脱数据中随机因素的干扰,得到稳定且正确的结论。


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330