机器学习中的梯度下降法
最优化问题是机器学习算法中非常重要的一部分,几乎每一个机器学习算法的核心都是在处理最优化问题。
本文中我讲介绍一些机器学习领域中常用的且非常掌握的最优化算法,看完本篇文章后你将会明白:
什么是梯度下降法?
如何将梯度下降法运用到线性回归模型中?
如何利用梯度下降法处理大规模的数据?
梯度下降法的一些技巧
让我们开始吧!
梯度下降法
梯度下降法是一个用于寻找最小化成本函数的参数值的最优化算法。当我们无法通过分析计算(比如线性代数运算)求得函数的最优解时,我们可以利用梯度下降法来求解该问题。
梯度下降法的直觉体验
想象一个你经常用来吃谷物或储存受过的大碗,成本函数的形状类似于这个碗的造型。
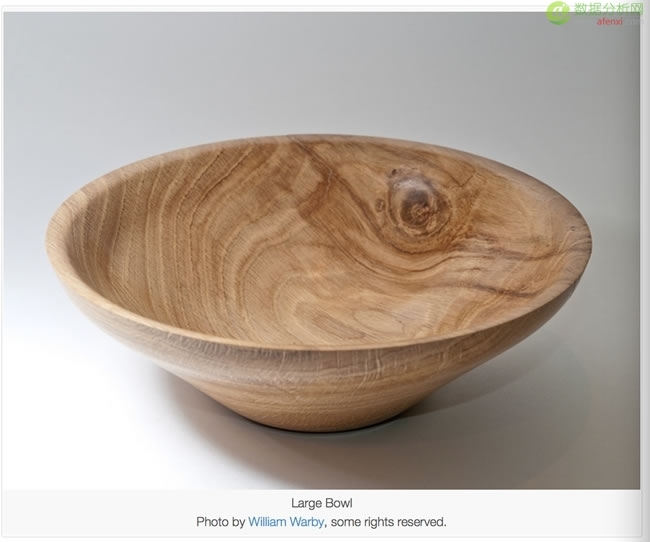
碗表面上的任一随机位置表示当前系数对应的成本值,碗的底部则表示最优解集对应的成本函数值。梯度下降法的目标就是不断地尝试不同的系数值,然后评估成本函数并选择能够降低成本函数的参数值。重复迭代计算上述步骤直到收敛,我们就能获得最小成本函数值对应的最优解。
梯度下降法的过程
梯度下降法首先需要设定一个初始参数值,通常情况下我们将初值设为零(coefficient=0coefficient=0),接下来需要计算成本函数 cost=f(coefficient)cost=f(coefficient) 或者 cost=evaluate(f(coefficient))cost=evaluate(f(coefficient))。然后我们需要计算函数的导数(导数是微积分的一个概念,它是指函数中某个点处的斜率值),并设定学习效率参数(alpha)的值。
coefficient=coefficient−(alpha∗delta)
coefficient=coefficient−(alpha∗delta)
重复执行上述过程,直到参数值收敛,这样我们就能获得函数的最优解。
你可以看出梯度下降法的思路多么简单,你只需知道成本函数的梯度值或者需要优化的函数情况即可。接下来我将介绍如何将梯度下降法运用到机器学习领域中。
批量梯度下降法
所有的有监督机器学习算法的目标都是利用已知的自变量(X)数据来预测因变量(Y)的值。所有的分类和回归模型都是在处理这个问题。
机器学习算法会利用某个统计量来刻画目标函数的拟合情况。虽然不同的算法拥有不同的目标函数表示方法和不同的系数值,但是它们拥有一个共同的目标——即通过最优化目标函数来获取最佳参数值。
线性回归模型和逻辑斯蒂回归模型是利用梯度下降法来寻找最佳参数值的经典案例。
我们可以利用多种衡量方法来评估机器学习模型对目标函数的拟合情况。成本函数法是通过计算每个训练集的预测值和真实值之间的差异程度(比如残差平方和)来度量模型的拟合情况。
我们可以计算成本函数中每个参数所对应的导数值,然后通过上述的更新方程进行迭代计算。
在梯度下降法的每一步迭代计算后,我们都需要计算成本函数及其导数的情况。每一次的迭代计算过程就被称为一批次,因此这个形式的梯度下降法也被称为批量梯度下降法。
批量梯度下降法是机器学习领域中常见的一种梯度下降方法。
随机梯度下降法
处理大规模的数据时,梯度下降法的运算效率非常低。
因为梯度下降法在每次迭代过程中都需要计算训练集的预测情况,所以当数据量非常大时需要耗费较长的时间。
当你处理大规模的数据时,你可以利用随机梯度下降法来提高计算效率。
该算法与上述梯度下降法的不同之处在于它对每个随机训练样本都执行系数更新过程,而不是在每批样本运算完后才执行系数更新过程。
随机梯度下降法的第一个步骤要求训练集的样本是随机排序的,这是为了打乱系数的更新过程。因为我们将在每次训练实例结束后更新系数值,所以系数值和成本函数值将会出现随机跳跃的情况。通过打乱系数更新过程的顺序,我们可以利用这个随机游走的性质来避免模型不收敛的问题。
除了成本函数的计算方式不一致外,随机梯度下降法的系数更新过程和上述的梯度下降法一模一样。
对于大规模数据来说,随机梯度下降法的收敛速度明显高于其他算法,通常情况下你只需要一个小的迭代次数就能得到一个相对较优的拟合参数。
梯度下降法的一些建议
本节列出了几个可以帮助你更好地掌握机器学习中梯度下降算法的技巧:
绘制成本函数随时间变化的曲线:收集并绘制每次迭代过程中所得到的成本函数值。对于梯度下降法来说,每次迭代计算都能降低成本函数值。如果无法降低成本函数值,那么可以尝试减少学习效率值。
学习效率:梯度下降算法中的学习效率值通常为0.1,0.001或者0.0001。你可以尝试不同的值然后选出最佳学习效率值。
标准化处理:如果成本函数不是偏态形式的话,那么梯度下降法很快就能收敛。隐蔽你可以事先对输入变量进行标准化处理。
绘制成本均值趋势图:随机梯度下降法的更新过程通常会带来一些随机噪声,所以我们可以考虑观察10次、100次或1000次更新过程误差均值变化情况来度量算法的收敛趋势。
总结
本文主要介绍了机器学习中的梯度下降法,通过阅读本文,你了解到:
最优化理论是机器学习中非常重要的一部分。
梯度下降法是一个简单的最优化算法,你可以将它运用到许多机器学习算法中。
批量梯度下降法先计算所有参数的导数值,然后再执行参数更新过程。
随机梯度下降法是指从每个训练实例中计算出导数并执行参数更新过程。
如果您对于梯度下降法还有疑问,请在评论区留下你的问题,我将尽我所能回答。


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330