京公网安备 11010802034615号
经营许可证编号:京B2-20210330
大数据之基于模型的复杂数据多维聚类析(二)
在隐树模型中,一个隐变量对应一种数据聚类的方法。隐树模型允许模型中有多个隐变量,所以自然地可以多维同时聚类。在例子模型中,可以按照分析能力或者语言能力对学生聚类,也可以按照智力对学生聚类。在隐树模型中,聚类分析可以通过计算给定学生成绩的后验概率进行判断。所以,利用隐树模型进行多维聚类分析的技术重点就在如何通过观测数据学习一个最优的模型。抽象地说,就是找到能够最好地解释数据的一个生成隐树模型(Generative Latent tree model)。
隐树模型的学习
隐树模型的学习是一个对模型逐步优化的过程,优化的目标函数是一个称为贝叶斯信息准则(Bayes information criterion, 简称BIC) 的函数:
BIC(m|D) = max θ log P(D|m, θ) – d(m)logN/2
BIC准则要求模型与数据尽量紧密地拟合,但其复杂不能过高。所以式中第一项表示拟合程度,而第二项是对于模型复杂度的一个惩罚项。我们的优化过程是一个基于搜索的爬山算法(Hill-Climbing)。以只包含一个隐变量的简单的隐树模型作为搜索的起始模型,在搜索的过程中,逐步引入新的隐变量、增加隐变量的取值个数、或者调整变量之间的连接。这是一个逐步修改模型的过程,在这个过程中,模型与数据的拟合程度不断改进,从而BIC分逐步增加。当模型就变得太复杂时,BIC会不升反降,于是搜索过程停止。
隐树模型的学习是一个非常耗时的过程,主要原因在于对于BIC分数的计算。BIC函数的第一项叫做最大似然函数,在模型包含缺失值或者隐变量时,计算最大似然函数需要调用EM(Expectation-Maximization)算法。尽管我们已经对于限制了模型结构为简单的树状结构,但是在这样的模型上进行EM的计算依然是非常困难。围绕隐树模型的很多工作都是在研究如何对模型学习进行加速的,这儿就不赘述了。
基于隐树模型的多维聚类分析实例
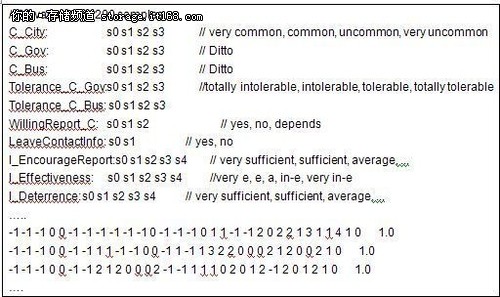
我们以一个真实的数据分析实例来展现多维聚类分析。数据来自某地区的关于贪污的社会调查问卷。通过一些数据预处理,我们的数据(如图所示)包含了1200份的问卷,以及31个问题。比如说C_City表示被访问者对于该地区的贪污普遍性的看法,可以有4个选项,分别是非常普遍,普遍,不普遍,以及非常不普遍。C_Gov和C_Bus分别表示受访者对于该地区政府部门或商业部门的贪污普遍性的看法,同样也有四个选项。Tolerance_C_Gov和Tolerance_C_Bus则分别表示受访者对于该地区的政府部门以及商业部门的贪污的容忍程度,可以选择完全不能容忍,不能容忍,能容忍,完全能容忍。数据表里面的-1表示受访者对该问题的回答缺失。
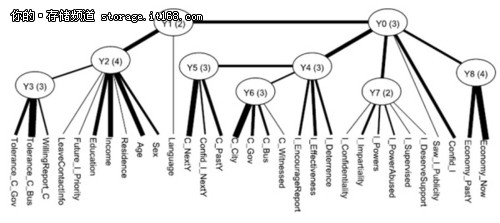
利用隐树的学习算法,我们从这个数据得到了一个如图所示的模型。叶节点对应问卷问题,即显变量。中间结点,Y0-Y8是从数据中发现的隐变量,括号里面的数字表示这个变量所取的状态个数。我们发现这些隐变量都有一定的意义,比如,Y2和问卷中的Sex,Age,Income,Education这些问题紧密连接,说明Y2应该是表示受访人的人口统计信息。Y3和问卷中的Tolerance_C_Gov和Tolerance_C_Bus紧密联系,说明Y3是反映受访者总体对于贪污的看法。
模型中的每个隐变量表示数据聚类的一种方式。比如,变量Y2有4个值,说明Y2提示数据可以分成四个类。这种聚类主要基于Sex,Age,Income,Education这些人口统计信息相关变量的,所以可以说当我们关注人群的人口统计信息这个侧面时,我们可以根据Y2把人群分成四类。具体地研究这四类的类条件概率(Class-Conditional ProbabilityDistribution)特性,我们进一步发现它们分别代表:低收入的年轻人群,低收入的女性人群,受过高等教育的高收入人群,以及只接受初等教育的一般收入人群。同时,我们看到Y3有3个取值,这说明从人群对于贪污总体看法这个侧面出发,可以把人群分成三类,分别是对于贪污完全不能容忍的人群,对于贪污比较不能容忍的人群,对于贪污可以容忍的人群。同样地,我们的聚类也可以基于其他隐变量所代表的侧面。这样从模型中我们得到了9种聚类的方法,达到了多维同时聚类的效果。
数据分析咨询请扫描二维码
若不方便扫码,搜微信号:CDAshujufenxi
在传统零售行业同质化竞争激烈、大众营销转化率持续走低的背景下,依托经验与直觉的粗放式营销逐渐失效。美国塔吉特百货(Target ...
2026-10-10随着智能客服、数字化服务、用户精细化运营的快速普及,传统零散、非标准化的客户服务数据与业务体系逐渐难以支撑高效服务治理。 ...
2026-10-10 很多数据分析师能熟练地写SQL、做透视表、算描述性统计,但当被问到“如何预测用户流失概率”“如何归因销量下滑的关键因素 ...
2026-10-10CDA数据分析师 出品 作者:李诗怡 定义区别 · 场景举例 · 指标分类 · 计算方法 知识体系总览 模块 包含内容 一、核 ...
2026-10-09在数据分析工作流中,业务数据大多存储在各类关系型数据库内,例如MySQL、PostgreSQL、SQLite等。Pandas是Python生态中主流的数 ...
2026-10-09在数字化精细化运营时代,海量用户存在需求差异、行为差异、价值差异与偏好差异。如果企业采用“一刀切”的统一营销、统一服务、 ...
2026-10-09 很多数据分析师拿到数据就开始清洗、建模,但当被问到“这批数据属于什么类型——结构化还是非结构化?分类变量还是数值变量 ...
2026-10-09指标体系是企业数字化分析、业务监控、经营决策的核心基础框架,是将零散数据转化为可衡量、可对比、可落地业务价值的关键体系。 ...
2026-10-08随着市场竞争日趋饱和,同质化低价竞争逐渐陷入内卷僵局,传统以价格、渠道、促销为核心的营销模式边际效益持续递减。在此背景下 ...
2026-10-08 很多数据分析师画过趋势图、做过业绩预测,但当被问到“这个月销售额增长20%,到底是长期趋势自然增长,还是促销活动的短期 ...
2026-10-08你有没有想过,手机里点外卖、刷社交软件、转一笔账,背后到底是谁在替你"记着账"? 答案其实很简单:数据库,以及跟它对话的那 ...
2026-10-07CDA数据分析师 出品 作者:李诗怡 一、数据分析四大思维 1. 对比思维:没有对比就没有分析 核心观点:单独一个数字没有意义,有 ...
2026-10-05Kimball 是方法,星型模型是它产出的形状。 很多人把"Kimball vs 星型模型"当成一道选择题——这本身就是个误会:Kimball 是动词 ...
2026-10-05写在开头 老板在微信上甩来一句: "帮我看下为什么销量跌了。" ” 你回工位,打开 SQL,开始写。查订单表、拉近三个月、按 ...
2026-10-03CDA数据分析师 出品 作者:李诗怡 1. 事实表 vs 维度表 对比维度 事实表 维度表 核心问题 记录“业务发生了什么事” 描述 ...
2026-10-02做数据聚合时,PySpark的groupBy()确实能完成统计,这也是它的本职工作。但它有一个根本性局限:每一组数据,最终只能返回一行 ...
2026-10-01热力地图是数据可视化中极具辨识度与实用性的空间分析图表,结合地理空间维度与数据密度特征,通过颜色深浅、色阶渐变直观展示数 ...
2026-09-30 很多数据分析师做过按月份的销售额趋势图,画过按天的流量折线图,但当被问到“时间序列和普通数据有什么本质区别”“季节性 ...
2026-09-30同样是“银行数据岗”,在国有大行总行数据中心、在一家城商行的零售部、在银行系金融科技子公司、在保险公司,工作内容、成长节 ...
2026-09-29在数据分析与统计学研究中,数据往往不是独立存在的,不同变量之间普遍存在相互关联、相互影响的关系。相关性统计分析是挖掘变量 ...
2026-09-29