CDA数据分析师 出品
作者:李诗怡
一、数据分析四大思维
1. 对比思维:没有对比就没有分析
核心观点:单独一个数字没有意义,有对比才有判断。例如“小明考了85分”——对比全班平均75分(横向)、他上次90分(纵向),结论完全不同
- 横向对比:和别人比——同行、不同渠道、不同地区,看自己处于什么位置
记忆点:同一分数,对比对象不同,结论完全不同
2. 细分拆解思维:把整体拆开看
核心观点:整体出问题时,拆开看才能定位病根。把整体指标按某维度拆成小部分分别看,哪部分异常,问题就在哪
思路链条:整体出问题 → 按维度拆 → 找异常 → 定位问题
常用维度:时间、渠道、人群、产品、地区
使用原则:不知道问题在哪 → 多维度都拆一遍;有假设 → 按假设相关维度拆
经典案例:店铺总转化率下降 → 按渠道拆分 → 仅A渠道暴跌 → 问题锁定A渠道,无需全盘排查
3. 归因思维:找到问题的真正原因
核心观点:发现问题只是第一步,找到原因才能解决问题。只有找到真正原因,解决方案才有效
三者分工:对比告诉你“发生了什么”,拆解告诉你“问题在哪”,归因告诉你“为什么会这样”
经典案例:留存率下降 → 按版本拆,新版本留存低 → 注册流程多一步 → 真正原因:注册变复杂 → 解决方案:简化注册流程,而非盲目发优惠券
4. 逻辑树思维:把问题层层拆解
定义:把大问题像树一样层层拆成小问题,直到小问题可以直接回答。逻辑树是MECE原则的典型应用
与细分拆解区别:细分拆解:按一个维度把整体分成部分,是“横向切”;逻辑树:从问题出发层层追问“为什么/怎么办”,是“纵向挖”
| 类型 |
拆的问题 |
说明 |
| 议题树 |
是什么 |
把大问题拆成小问题 |
| 假设树 |
为什么 |
先假设原因,再验证 |
| 是否树 |
怎么办 |
用是/否判断引导决策 |
5. 目标思维:先定目标再分析
核心观点:没有目标的数据分析是瞎分析。拿到数据先问:我要解决什么问题?
SMART原则:定目标的标准:S具体、M可衡量、A可实现、R相关、T有时限
6. 样本思维:数据不等于全部
核心观点:你看到的数据可能只是一部分。用样本推断总体时,样本必须有代表性
| 样本偏差 |
含义 |
| 幸存者偏差 |
只看到活下来的,没看到死掉的 |
| 选择偏差 |
抽样方法有问题 |
| 缺失偏差 |
数据缺失导致结论偏差 |
考试关键词:目标思维:“先定目标再分析”“SMART原则”;样本思维:“样本代表性”“幸存者偏差”“选择偏差”“数据缺失”
二、六步方法论详解
口诀:目采清处分结:目标 → 采集 → 清洗 → 处理 → 分析 → 结论。标准流程六步走,不会漏环节
1. 明确目标:5W2H法定目标
核心:做分析前先问清楚:要解决什么问题、为谁解决、什么时候要。目标不清晰,后面全白做
| 要素 |
回答的问题 |
| Why 为什么 |
为什么要做这个分析?业务背景是什么? |
| Who 为谁做 |
给谁看?老板、运营还是产品? |
| When 何时要 |
什么时候要结果?日报、周报还是专题? |
| Where 在哪看 |
数据从哪来?分析哪个范围? |
| What 做什么 |
分析什么问题?提升销量?降低成本? |
| How 怎么做 |
用什么方法?对比?拆解?归因? |
| How much 做到什么程度 |
目标要可衡量,如“Q3销量提升20%”,不是“提升销量” |
2. 数据采集:需要什么,从哪来
核心:目标定清楚后,问:要回答这个问题需要哪些数据?数据从哪来?
| 数据来源 |
说明 |
数据类型 |
| 业务数据库 |
订单、用户、商品等,用SQL查询 |
结构化数据 |
| 日志数据 |
用户行为埋点:点击、浏览、停留 |
半结构化数据 |
| 外部数据 |
行业报告、爬虫、API接口、公开数据,补充内部不足 |
外部补充 |
| 人工录入 |
问卷、调研、Excel手工录入 |
人工数据 |
采集质量注意:①数据口径一致:同一指标不同来源定义可能不同,必须先统一口径;②数据范围明确:时间、业务、用户范围要和目标匹配,不能多采也不能漏采
3. 数据清洗:垃圾进,垃圾出
核心:数据质量决定分析质量,脏数据做出来的分析一定是错的。清洗是最花时间的一步(占60%-80%)
| 质量标准 |
含义 |
| 完整性 |
没有缺失值 |
| 准确性 |
没有异常值、错误值 |
| 一致性 |
口径统一、格式统一 |
| 唯一性 |
没有重复数据 |
缺失值五种处理:①删除 ②均值/中位数填充 ③众数填充 ④前后值填充 ⑤模型预测
异常值三种判断:①业务经验判断 ②统计方法判断 ③对比判断
4. 处理计算:把数据变成指标
核心:清洗后的数据是原始数据,需要计算、转换、聚合,变成能分析的指标
| 指标类别 |
常用指标 |
| 集中趋势 |
均值、中位数、众数 |
| 离散程度 |
方差/标准差、极差、四分位距 |
| 分布形态 |
偏度、峰度、频率分布 |
数据处理三动作:①数据转换:单位统一、格式转换、编码转换;②数据聚合:按天/周/月汇总、按维度分组汇总;③衍生指标:从原始数据计算新指标
5. 数据分析:用思维找规律
核心:用前面学的四大思维,从数据中找规律、找原因、找机会
| 分析层次 |
回答的问题 |
所用思维 |
| 描述分析 |
发生了什么?销售额多少、增长多少 |
对比思维 |
| 诊断分析 |
为什么发生?哪个渠道出问题 |
拆解 + 归因思维 |
| 预测分析 |
将来会怎样?下个月销售额多少 |
趋势 + 模型 |
| 决策分析 |
该怎么办?投哪个渠道 |
逻辑树 + 假设 |
常用方法:①对比分析:和目标比、和历史比、和行业比;②细分分析:按维度拆解找异常;③归因分析:找根本原因;④相关分析:看变量之间的关系
6. 结论建议:分析的最终目的
核心:不能只摆数据,要告诉业务“该怎么办”。数据分析的价值不在于分析本身,而在于驱动决策和行动
好建议三标准:①有依据 ②可执行 ③有预期
结论结构(金字塔):结论先行:先说核心结论 → 论据支撑:再用数据支撑 → 建议落地:最后给建议
 扫码 CDA 认证小程序
获取更多资料
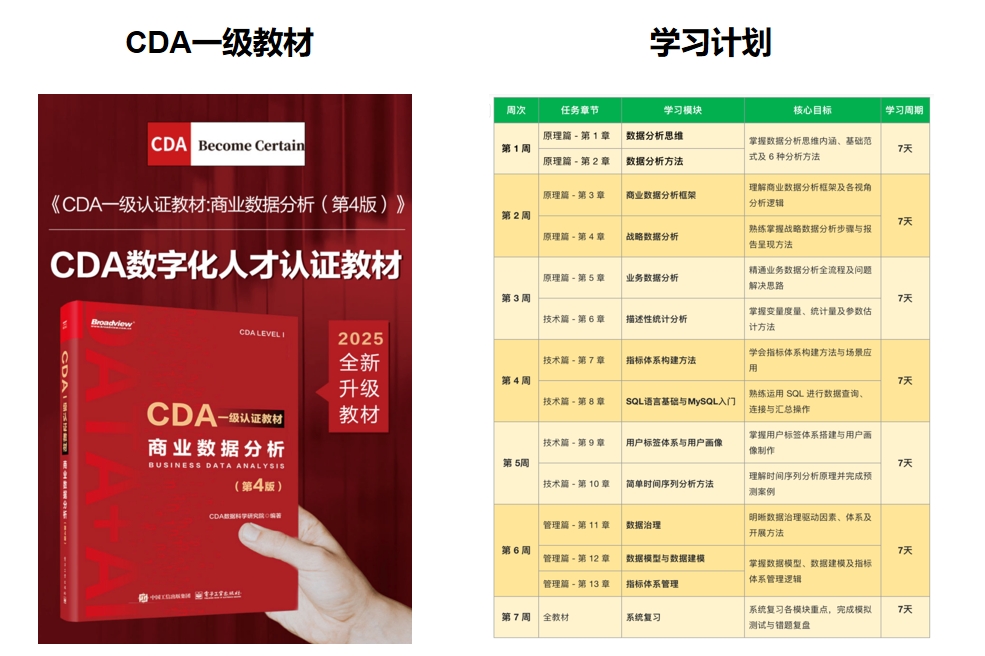
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330