我发现我的数据可能被操纵了……
当前,我们正目睹着一场数据被滥用的“大剧”。限制数据滥用、努力解决偏见数据和问题数据,正成为科技对社会产生影响的关键。
简而言之,我认为大家应该重新考虑,安全、公平到底意味着什么。本文从三个方向来讨论,在数据驱动的世界中,我们的数据有可能被操纵。
操纵数据的原罪者——谷歌
1998年,两个斯坦福毕业生决心着手解决主流搜索引擎存在的问题。
Sergey
Brin和Larry
Page合作撰写了一篇论文,描述他们的网页排序算法怎样解决搜索结果中垃圾网页过多的问题。他们的想法意义非凡,如今被人们认为是谷歌创立的基石。但是就算这样,也没法阻止人们通过更先进的算法来来干扰网络数据。事实上,谷歌在后来发展的过程中,为了广告插入也进一步操控排名,在一定程度上阻碍了搜索引擎的进一步优化。
时光流转到2003年,当宾夕法尼亚参议员Rick
Santorum公开将同性恋类比人兽交和恋童癖时,LGBT群体被激怒了。媒体Dan
Savage呼吁读者们做点什么以记住这个时刻,其中一位粉丝创建了一个网站,网站内容中将Santorum这个名字与“肛交”一词联系到一起。令这位参议员不寒而栗的是,有人利用网民的力量,将网站链接推送到搜索引擎结果靠前的位置。
这种众包形式的搜索引擎优化行为被称作“谷歌爆炸”,也是一种媒体炒作形式,旨在干扰数据和信息环境。
媒体炒作和网络失真信息(封面),2017年3月,Jim Cooke绘制的插图
媒体炒作并不新颖。正如许多人所知,宣传和社交媒体营销的界线通常是模糊的。除此以外,那些通过点赞、评论和订阅量等公共信号宣传产品特点的公司都熟知,任何被创造的系统都将成为娱乐、利益、政治、意识形态和权力游戏的舞台,甚至连国会现在都在为此斗争。
而除了这些已经发生的,我们还正在面临哪些数据被操纵的情况?我们又该如何应对?
骗过网络系统
如同搜索引擎,现在社交媒体成了一个全新的炒作目标,吸引了从社交媒体营销号到国家行为发言人的各类人群。干扰Twitter热门话题或者Facebook新闻动态成为许多人的嗜好。任何人只要5美金,几乎在所有主要网站上都能轻而易举地买到粉丝(关注者)、点赞数和评论量。背后的经济和政治动机显而易见,但除了这些势力强大的水军,还有一大群人毫无目标地参与网络攻击。
例如,自Rick
Astley的歌曲《Never Gonna Give You
Up》推出时隔20年后,有这么一群人决定帮他再登歌曲排行榜首,目的并不是帮Rick
Astley赚钱(尽管有此效果)。但通过这样的方式,大量普通用户学会了如何让某些信息被病毒式传播或者干扰网络系统的方法。换句话说,他们学会了如何获得注意力。通过这些行为,他们搞出了一套能够造成严重后果的炒作策略。
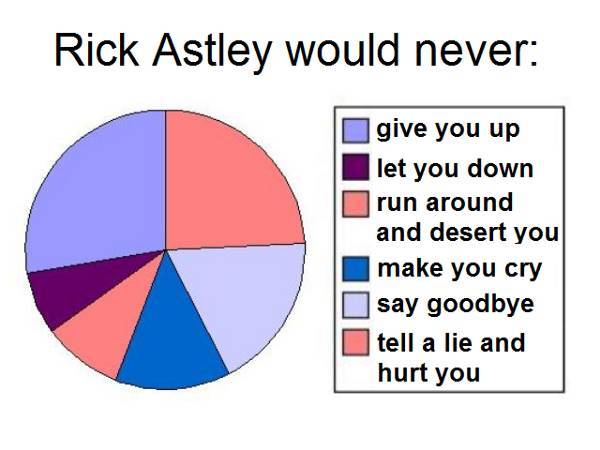
一个炒作Rick Astley的例子
像“披萨门”这类的事件并非偶然,这是一群网民愚弄信息系统的产物。(注:披萨门是去年美国大选期间发生的阴谋论,怀疑希拉里竞选经理被曝出的电子邮件中,包含利用一系列餐厅进行人贩子生意的暗语。这个阴谋论已经数次被有关部门反驳和攻破。)他们创造了许多被称做“马甲”的跨平台网络虚假账户,这些账户巧妙地影响媒体和其他势力团体,引发他们对精心设定的问题、博文和网络视频的关注。这种事件的编造并不是为了让媒体信以为真,而是让这些媒体傻傻地通过大量自有宣传渠道否定它。这样就产生了“反向效应”,那些不相信媒体的人认定这其中必有一些阴谋论,从而鼓励一些人自发调查。
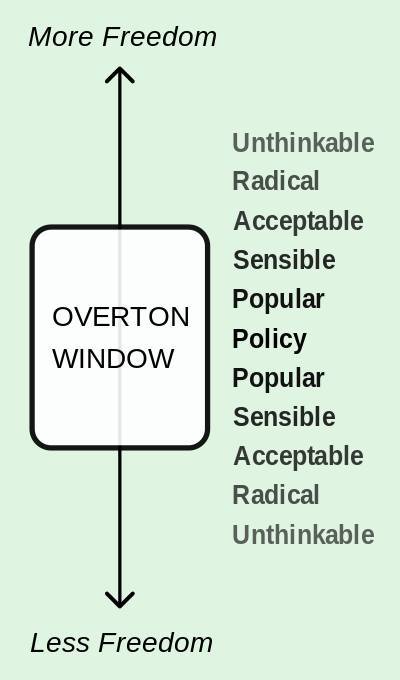
接着就有铺天盖地的评论要求“打开窗口”——增加公共讨论话题的尺度。媒体们被骗去散播问题事件。更有甚者,推荐引擎会被用于向问题事件的被动接受者推送更多相关内容。再举个例子,
研究员Joan
Donovan主要研究白人至上主义,工作之余,她打开Amazon、Netflix或是YouTube,每个网站都她推荐消费新纳粹主义音乐、视频和其他周边。一些激进分子也知道如何变本加厉制造问题。不用触犯Twitter的任何保护机制,那些人可以想方设法利用公司广告内容放大白人优越主义思想,引发关注社会公平群体的愤怒。
总体来说,这些伎俩是对算法系统的手动攻击。但我们都知道,攻击的方法一直在变化,不在仅仅是手动。而现在,一切即将再次改变。
脆弱的训练集
训练机器学习系统需要数据,而且是海量数据。尽管目前已经建成了一批标准化语料库,计算机科研人员、初创企业和大公司对于新的、差异化的数据的需求依然有增无减。
首当其冲的问题就是所有数据都带有偏见。从总体上看,人和社会的偏见反映得最为明显。以当下很红的数据集ImageNet为例,人类根据形状进行分类的速度,远高于根据颜色进行分类;受此影响,数据集最终会包含一些奇形怪状的人造物体。
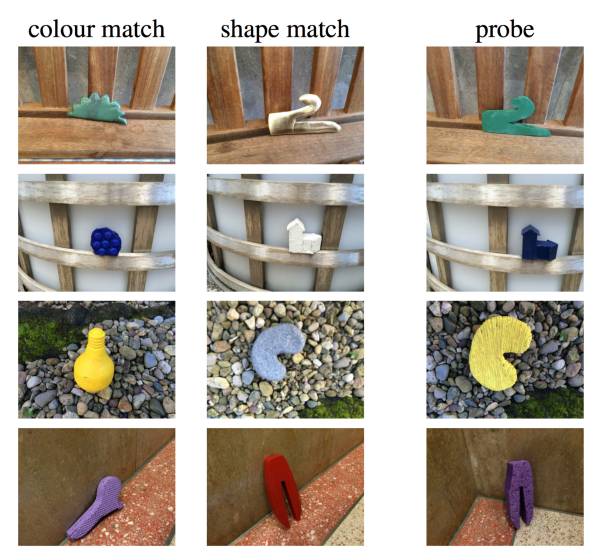
深度神经网络中的认知心理学:形状偏见的个案研究,2017年6月29日
在应对社会偏见时,局面会变得更加混乱无章。Latanya Sweeney在谷歌上搜索自己的姓名时,惊讶地发现有广告邀请她查询自己是否有犯罪记录。作为一名计算机科学家,她决定在系统上跑一批常见的白人名字和黑人名字,看看哪些名字会招来广告。不出所料,招来这种刑事类产品的都是黑人名字。这并不是因为谷歌知道怎样“看名字下菜碟”,而是因为搜索用户在搜索黑人姓名时,点击刑事类广告的几率更高。谷歌把“种族歧视”学了过来并“发扬光大”,最终影响了全部用户。
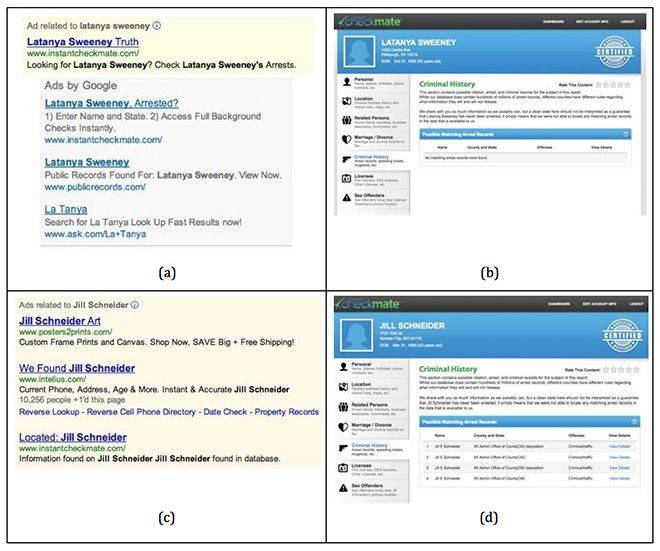
A和C显示的是针对两个人各自姓名出现的广告,B和D表明该广告暗示存在犯罪前科所根据的是姓名类型,而非就是此人的档案
不论是对人进行分类的数据还是由人进行分类的数据,只要想以此为基础建立系统,文化偏见都将成为巨大的挑战。
不过还有一项新的挑战正在日渐成型:散布在不同网络中的人群和国家行为者。他们在社交网络上兴风作浪,搜索引擎对于相应数据的关注度却与日俱增,而各家公司正是用这些数据来训练、改进系统的。
举个例子,假设用Reddit和Twitter的数据来做训练。这些公司在API上表现得非常大方,计算机科学家们长期以来也从这里抓取了大量数据来训练各种模型,试图理解自然语言、围绕链接开发源语言、以及追踪社会模式。他们训练各种模型来检测抑郁症、为新闻排序,并参与到会话当中,但忽略了这些数据从一开始就不具有代表性。
绝大多数用这些API工程师都相信他们可以清洁抓到的数据,并去除所有的问题内容,可事实并非如此。不论删除多少特定的subreddits、推文种类,亦或是忽略包含问题词语的内容,这些操作都不会让你在那些诚心找茬的人面前占据先机。
无数人或者组织用尽各种方式想要混淆公共数据,大公司的系统也在他们的目标范围之列。他们试图通过低空飞行避开雷达监管。如果你没有准备好相应的系统,从战略层面去应对这些早有准备绕开你精心制定的计划的人,你简直不堪一击。这与意外或自然内容无关,甚至也牵扯不到带有文化偏见的数据。
如果你想要理解这到底是什么意思,不妨想想Nicolas
Papernot和他的同事于去年发表的实验。为了深入掌握计算机图像算法的弱点,他们决定改变交通停止标志的图形外观,即使底层神经网络会将之解读为放行标志,但在肉眼看来它依然代表交通停止。想想看,这对于汽车来说意味着什么。如果分类标准能够如此轻易地任人攻破,这项技术还能得到广泛应用吗?
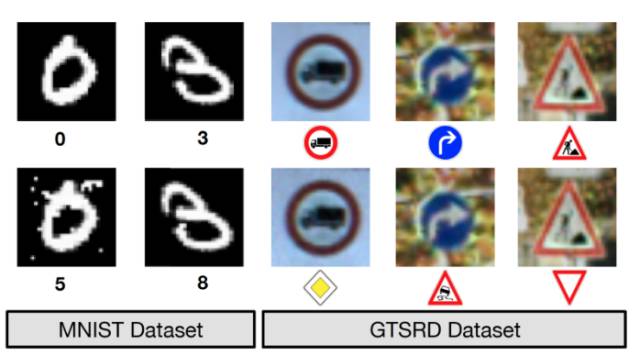
《攻击机器黑匣子实用教程》,2017年3月19日。研究人员改变了第一行的图像,以误导神经网络,并导致了最后一行的错误解读
迄今为止,针对机器学习模型展开的最成功数据注入攻击发生在研究领域。但我们也发现越来越多的人试图在主流系统中制造混乱,他们目前还没得手,但我们绝不能否认他们还在学习和试探。
打造技术抗体
数十年来,很多公司都没把安全漏洞当回事,直到系统被突破的消息一次又一次登上头条。在应对这个新问题上,我们还要重蹈覆辙吗?如果你正在构建数据驱动式的系统,你从现在就要开始考虑数据会以怎样的方式、被谁污染,以实现何种目的。
测试在这个技术行业中已经失去了生存的土壤,这个锅社交媒体是逃不掉的。15年前,我们一头扎向了“永久公开测试”,我们邀请公众成为我们的质保工程师。但是内部QA远比找BUG要复杂,它需要将对抗思维融入到设计和研发过程中。当搞破坏的人就隐藏在公众之中时,请大家为系统找漏洞的效果就不尽如意了。
进一步来说,当前不论是谁,在没动机、没渠道的情况下都没法在私下里告知我们问题所在。有些记者会找到瞒天过海的方法,把系统变成新纳粹主义的广告,借此来嘲笑我们,也只有此时我们才会注意到问题所在。然而尽管如此,更多包藏祸心的行动者开始和我们的数据玩起放长线钓大鱼的游戏。
为什么在魔高一丈之前,我们不抢先道高一尺呢?乐观的看,作为应急措施,很多研究人员都将在机器学习系统的研发中融入了对抗思维。
以生成性对抗网络(GANs)为例。那些对此不太熟悉的人可以这样理解:你手上有两个无人监督的机器学习算法,前者负责为具有评估功能的后者生成内容。前者试图骗后者接受“错误”信息,这样操作旨在找到模型和数据之间的界限。我们需要更多这样的研发项目。随着对抗思维融入到模型搭建过程中,测试在研究领域也走到了尽头。
白帽子-“高举正义大旗”的黑客。举例来说,测试系统的安全性或漏洞(图片:CC Magicon, HU)
但这些研究的作用非常有限。我们需要积极主动、目标明确地构建相应文化,开展对抗测试、评估,并将之融入研发过程。我们需要构建分析方法,评估数据集中的偏见。我们还需要开发相应的工具来监督系统的运转情况,这方面需要的精力毫不逊于模型最初的搭建阶段。我的同事Matt
Goerzen认为除此之外,还需要有策略地邀请白帽子中的牛人介入到我们的系统之中,帮助我们查漏补缺。
技术行业已经不再是一群极客的狂欢,不再是“想要做点不一样的事情”那么简单,它是经济和信息世界的重要基石。我们必须从战略层面认真思考,他人想要以何种方式操纵数据为非作歹。


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330