文章来源:数据分析与统计学之美
作者:黄伟呢
1.概述
python字符串应该是python里面最重要的数据类型了,因此学会怎么处理各种各样的字符串,显得尤为重要。
我们不仅要学会怎么处理单个字符串,这个就需要学习“python字符串函数”,我们还要学会怎么处理二维表格中每一列每一格的字符串,这个就需要学习“pandas的str矢量化字符串函数”。
今天我们采用对比的方式,带大家总结常用的字符串函数,希望这篇文章能够对大家起到很好的作用。
在开始享用这篇文章之前,请培养好自己的耐心,本文确实干货满满,一定要看到最后你才知道收获有多大,尤其是后面的str属性,超有用。
2.常用的python字符串函数
字符串中,空白符也算是真实存在的一个字符。
1)python字符串函数大全
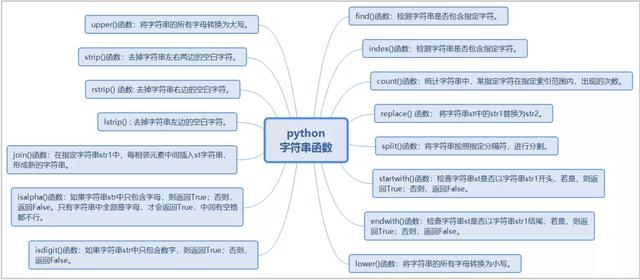
2)函数讲解
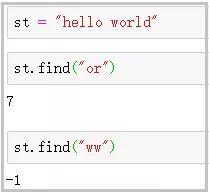
① find()函数
功能 :检测字符串是否包含指定字符。如果包含指定字符,则返回开始的索引;否则,返回-1.
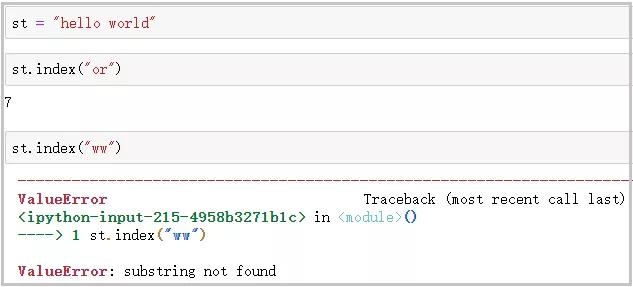
② index()函数
功能 :检测字符串是否包含指定字符。如果包含指定字符,则返回开始的索引;否则,提示ValueError错误。
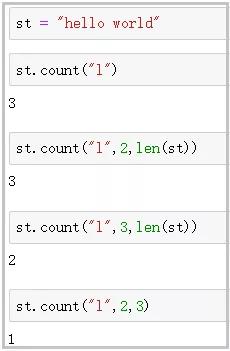
③ count()函数
功能 : 统计字符串中,某指定字符在指定索引范围内,出现的次数。
索引范围 :左闭右开区间。
注意 :如果不指定索引范围,表示在整个字符串中,搜索指定字符出现的次数。
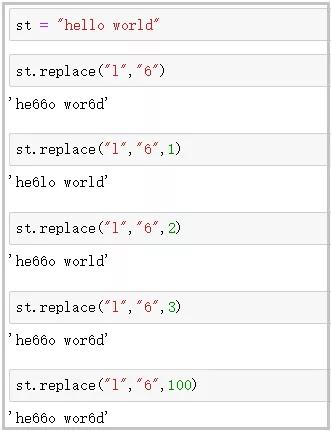
④ replace()函数
语法 :st.replace(str1.str2.count)。
功能 :将字符串st中的str1替换为str2.
注意 : 如果不指定count,则表示整个替换;如果指定count=1.则表示只替换一次,count=2.则表示只替换两次。
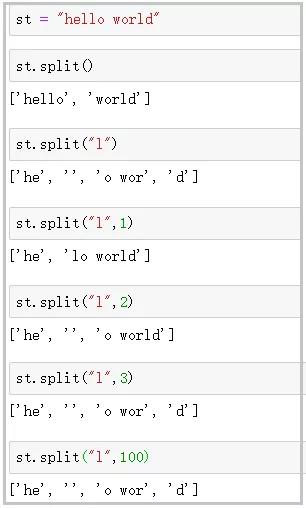
⑤ split()
语法 :st.split('分隔符', maxSplit)
功能 :将字符串按照指定分隔符,进行分割。
注意 :如果split中什么都不写,则默认按照空格进行分割;如果指定了分割符,则按照指定分隔符,进行分割。
maxSplit作用:不好叙述,自己看下面的例子就明白。
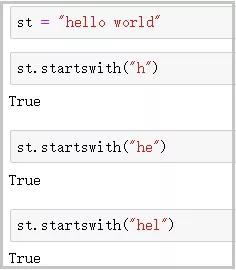
⑥ startswith()函数
语法 :st.startswith(str1)
功能 :检查字符串st是否以字符串str1开头,若是,则返回True;否则,返回False。
⑦ endswith()函数
语法 :st.endswith(str1)
功能 :检查字符串st是否以字符串str1结尾,若是,则返回True;否则,返回False。
⑧ lower()
语法 :st.lower()
功能 :将字符串的所有字母转换为小写。
⑨ upper()
语法 :st.upper()
功能 :将字符串的所有字母转换为大写。

⑩ strip()
语法 :st.strip()
功能 :去掉字符串左右两边的空白字符。
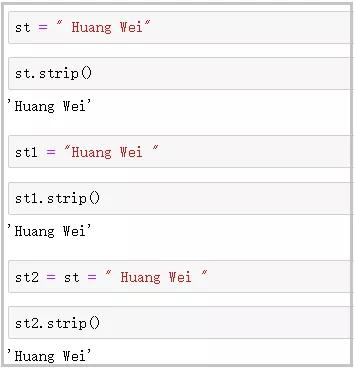
注1:st.rstrip() : 去掉字符串右边的空白字符。
注2:st.lstrip() : 去掉字符串左边的空白字符。
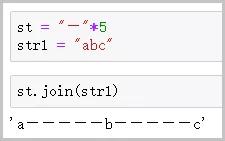
⑪ join()函数
语法 :st.join(str1)
功能 :在指定字符串str1中,每相邻元素中间插入st字符串,形成新的字符串。
注意 :是在str1中间插入st,而不是在st中间插入str1.
⑫ isalpha()
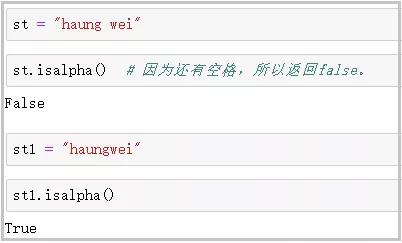
语法 :str.isalpha()
功能 :如果字符串str中只包含字母,则返回True;否则,返回False。
注意 :只有字符串中全部是字母,才会返回True,中间有空格都不行。
⑬ isdigit()
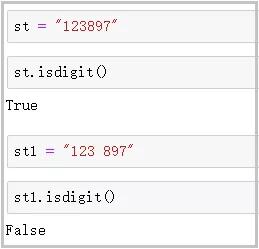
语法 :str.isdigit()
功能 :如果字符串str中只包含数字,则返回True;否则,返回False。
3.常用的str矢量化字符串函数
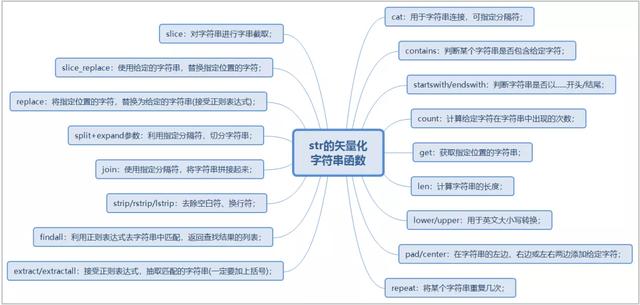
str矢量化操作:指的是循环迭代数组里面的某个元素,来完成某个操作。
1)str矢量化字符串函数大全
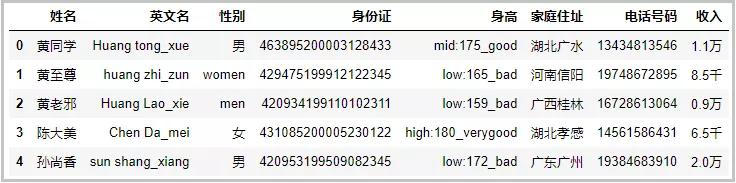
2)构造一个DataFrame,用于测试函数
import pandas as pd
df ={'姓名':[' 黄同学','黄至尊','黄老邪 ','陈大美','孙尚香'],
'英文名':['Huang tong_xue','huang zhi_zun','Huang Lao_xie','Chen Da_mei','sun shang_xiang'],
'性别':['男','women','men','女','男'],
'身份证':['463895200003128433','429475199912122345','420934199110102311','431085200005230122','420953199509082345'],
'身高':['mid:175_good','low:165_bad','low:159_bad','high:180_verygood','low:172_bad'],
'家庭住址':['湖北广水','河南信阳','广西桂林','湖北孝感','广东广州'],
'电话号码':['13434813546','19748672895','16728613064','14561586431','19384683910'],
'收入':['1.1万','8.5千','0.9万','6.5千','2.0万']}
df = pd.DataFrame(df)
df
结果如下:
3)函数讲解
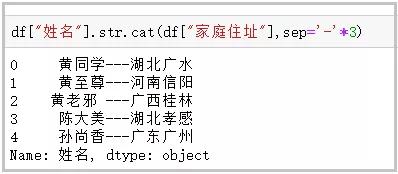
① cat函数:用于字符串的拼接
df["姓名"].str.cat(df["家庭住址"],sep='-'*3)
结果如下:
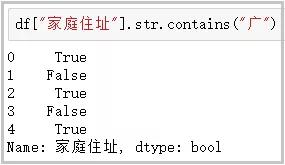
② contains:判断某个字符串是否包含给定字符
df["家庭住址"].str.contains("广")
结果如下:
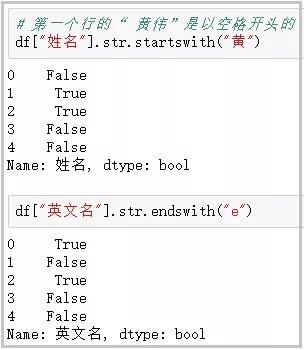
③ startswith/endswith:判断某个字符串是否以...开头/结尾
# 第一个行的“ 黄伟”是以空格开头的
df["姓名"].str.startswith("黄")
df["英文名"].str.endswith("e")
结果如下:
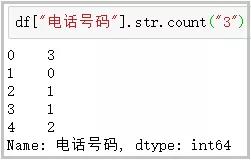
④ count:计算给定字符在字符串中出现的次数
df["电话号码"].str.count("3")
结果如下:
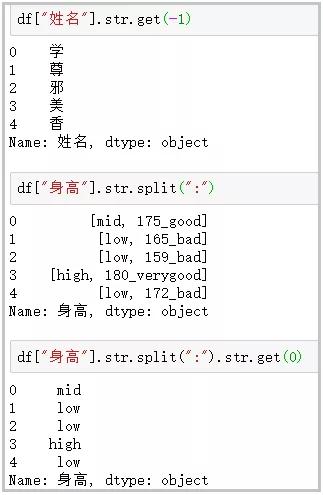
⑤ get:获取指定位置的字符串
df["姓名"].str.get(-1)
df["身高"].str.split(":")
df["身高"].str.split(":").str.get(0)
结果如下:
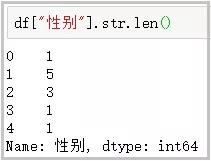
⑥ len:计算字符串长度
df["性别"].str.len()
结果如下:
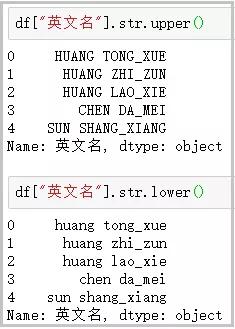
⑦ upper/lower:英文大小写转换
df["英文名"].str.upper()
df["英文名"].str.lower()
结果如下:
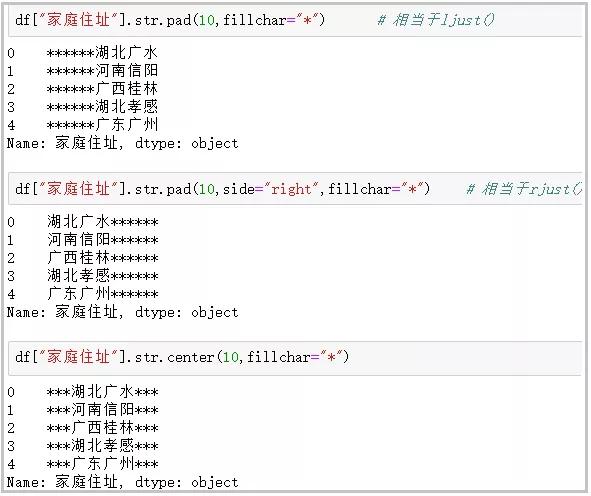
⑧ pad+side参数/center:在字符串的左边、右边或左右两边添加给定字符
df["家庭住址"].str.pad(10.fillchar="*") # 相当于ljust()
df["家庭住址"].str.pad(10.side="right",fillchar="*") # 相当于rjust()
df["家庭住址"].str.center(10.fillchar="*")
结果如下:
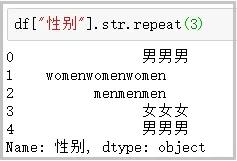
⑨ repeat:重复字符串几次
df["性别"].str.repeat(3)
结果如下:
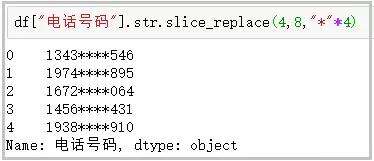
⑩ slice_replace:使用给定的字符串,替换指定的位置的字符
df["电话号码"].str.slice_replace(4.8."*"*4)
结果如下:
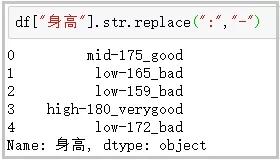
⑪ replace:将指定位置的字符,替换为给定的字符串
df["身高"].str.replace(":","-")
结果如下:
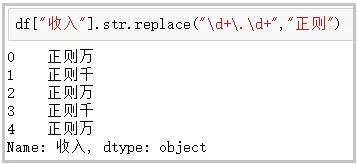
⑫ replace:将指定位置的字符,替换为给定的字符串(接受正则表达式)
replace中传入正则表达式,才叫好用;
先不要管下面这个案例有没有用,你只需要知道,使用正则做数据清洗多好用;
df["收入"].str.replace("\d+\.\d+","正则")
结果如下:
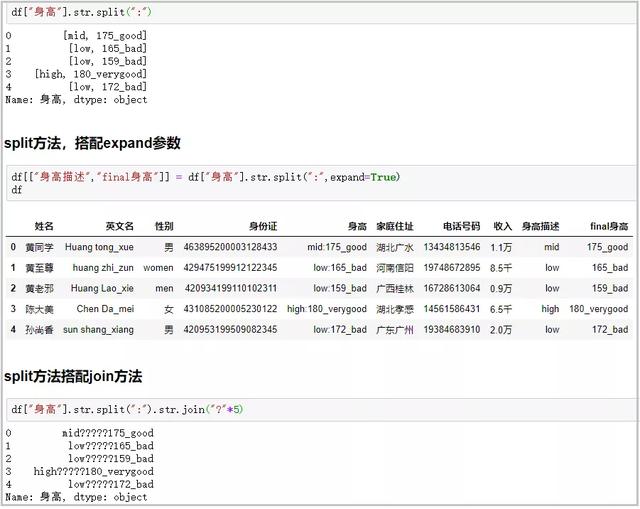
⑬ split方法+expand参数:搭配join方法功能很强大
# 普通用法
df["身高"].str.split(":")
# split方法,搭配expand参数
df[["身高描述","final身高"]] = df["身高"].str.split(":",expand=True)
df
# split方法搭配join方法
df["身高"].str.split(":").str.join("?"*5)
结果如下:
⑭ strip/rstrip/lstrip:去除空白符、换行符
df["姓名"].str.len()
df["姓名"] = df["姓名"].str.strip()
df["姓名"].str.len()
结果如下:

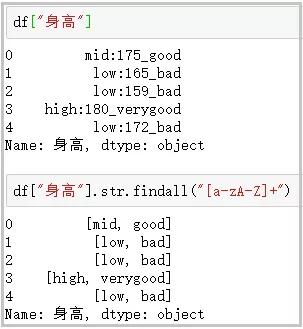
⑮ findall:利用正则表达式,去字符串中匹配,返回查找结果的列表
findall使用正则表达式,做数据清洗,真的很香!
df["身高"]
df["身高"].str.findall("[a-zA-Z]+")
结果如下:
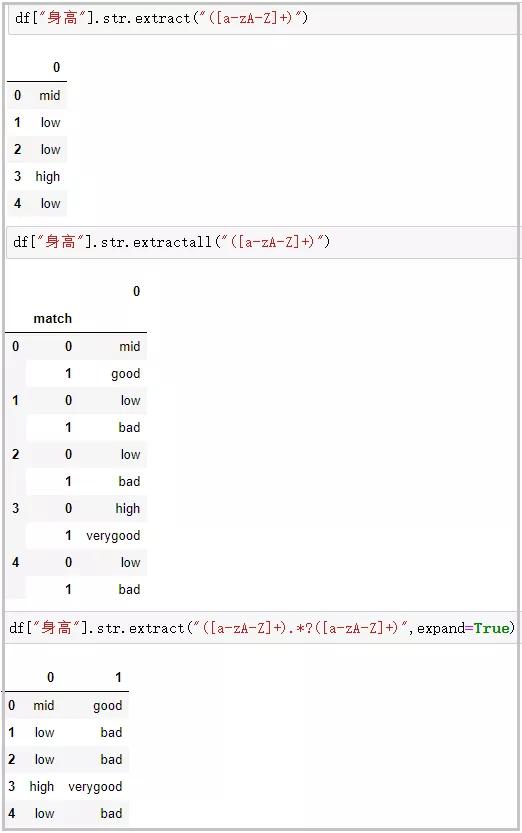
⑯ extract/extractall:接受正则表达式,抽取匹配的字符串(一定要加上括号)
df["身高"].str.extract("([a-zA-Z]+)")
# extractall提取得到复合索引
df["身高"].str.extractall("([a-zA-Z]+)")
# extract搭配expand参数
df["身高"].str.extract("([a-zA-Z]+).*?([a-zA-Z]+)",expand=True)
结果如下:


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330