在Python Pandas数据分析中,DataFrame是承载结构化数据的核心载体,数据清洗、数据修正、条件赋值、字段更新等实操场景,都离不开数据遍历与元素修改操作。遍历是逐行、逐列读取DataFrame数据的基础手段,而元素修改是在遍历基础上,对原始数据进行校正、更新与优化的核心操作。不同于普通Python列表遍历,DataFrame作为二维结构化数据表,存在索引对齐、数据类型约束、视图与副本差异等特性,错误的遍历修改方式极易引发数据报错、原值不更新、数据错乱等问题。本文将系统讲解DataFrame主流遍历方式、元素修改实操方法、各方法优劣对比与实战注意事项,为结构化数据处理提供标准化技术参考。
DataFrame遍历主要分为行遍历、列遍历、元素逐一遍历三类,核心目的是读取数据表中每一条记录、每一个字段的数值。元素修改则是基于遍历结果,结合业务规则、条件判断对目标单元格数据进行更新、替换、修正。
在实战数据分析中,该操作广泛应用于异常值修正、分类数据统一、数值区间赋值、缺失值批量填充、业务标签新增等场景。需要明确的是,Pandas不推荐低效的循环遍历修改,优先向量化操作,但针对复杂多条件、个性化修正场景,遍历修改仍是不可或缺的基础技能。
1. iterrows()行遍历修改(最常用、适配性广)
iterrows()是DataFrame专属行遍历方法,可逐行遍历数据表,返回每行的索引与行数据Series,是单行元素修改最常用的方式,语法简洁、可读性强,适合中小体量数据的精细化修改。
核心原理:遍历每一行数据,通过列名精准定位单元格元素,结合if条件判断、数值运算完成元素修改,可实现针对性、个性化的数据更新。
实战场景:学生成绩修正、商品价格调整、异常数值替换、单条数据个性化修改等。例如遍历成绩数据表,将低于60分的成绩统一修正为“不及格”标签,精准完成分类数据更新。
使用要点:iterrows()遍历出的行数据为只读视图,直接修改无法更新原表,必须通过行索引+列名的方式赋值修改,确保原值同步更新。
2. itertuples()遍历修改(高效快速)
itertuples()以元组形式逐行遍历数据,遍历速度远高于iterrows(),运行效率更高,适合大批量数据遍历修改。遍历过程中可通过属性名调用各列数据,完成条件判断与元素赋值。
核心优势:遍历性能优异、运行速度快,适配大数据量批量修改场景,稳定性更强。
局限性:列名会自动简化,特殊字符、中文列名可能出现属性调用异常,语法可读性略低于iterrows(),更适合标准化字段的数据修改。
3. loc索引遍历修改(精准可控、零报错)
loc是基于标签索引的精准操作方法,可结合循环遍历索引,通过“行索引、列名”精准定位任意单元格元素,是修改数据最安全、最精准的方式,能够完美规避数据视图与副本问题。
核心特点:直接作用于原DataFrame,赋值精准、无数据错位、无修改失效问题,支持单行、多行、批量元素修改,适配所有精细化数据校正场景,是课程作业与实战项目的推荐方法。
4. apply遍历修改(简洁高效、向量化优选)
apply函数通过自定义函数实现整列、整行数据批量遍历修改,无需手动编写for循环,代码简洁、运行高效,是Pandas官方推荐的优化写法。用户可自定义修改规则,通过apply批量遍历并更新所有元素,替代传统低效的for循环。
适用场景:整列数值统一运算、批量替换、规则化数据修正,例如分数统一加分、价格统一折扣、文本统一清洗等标准化修改场景。
三、各类遍历修改方法优劣与场景选型
iterrows():语法简单、可读性强、适配中文列名,适合新手练习、中小数据精细化修改,缺点是大批量数据运行速度较慢。
itertuples():遍历效率最高,适合大数据量批量修改,缺点是列名兼容性差、可读性弱。
loc索引法:精准安全、零数据异常,适配所有精细化、个性化修改场景,无明显短板,通用性最强。
apply函数法:代码简洁、高效优化,适合标准化批量修改,是替代循环遍历的最优方案。
1. 杜绝直接修改遍历临时数据
通过iterrows、itertuples遍历得到的是临时视图或临时数据对象,并非原表数据,直接对临时变量赋值无法修改原DataFrame元素,必须通过索引定位原表单元格完成赋值更新,避免修改失效。
2. 警惕SettingWithCopyWarning副本警告
对DataFrame切片后的子集进行遍历修改时,容易触发副本警告,导致数据修改不生效、原值保留等问题。解决方法为修改前通过copy()生成独立数据表,或直接使用loc原生索引赋值,规避视图与副本冲突。
遍历修改元素时,新赋值的数据类型需与原列字段类型匹配,避免数值列写入文本、浮点列写入整数,防止字段类型错乱,引发后续统计计算报错。
4. 优先使用向量化操作替代循环遍历
对于统一规则的批量修改,优先使用apply、条件筛选赋值等向量化操作,尽量减少for循环遍历。向量化运算依托Pandas底层优化,运行效率远高于手动循环,数据处理更稳定。
5. 避免索引混乱导致数据错位
遍历修改过程中,需保证行索引连续有效,若数据表存在索引断层、重复索引,需提前重置索引,防止修改元素时行列错位、数据匹配错误。
五、实战应用价值
DataFrame遍历与元素修改是Python数据清洗的核心基础技能,贯穿数据分析全流程。在实战中,可用于批量修正异常数据、统一分类标签、完善缺失数据、更新业务指标、生成衍生字段,将杂乱的原始数据修正为规整、标准的结构化数据,为后续的数据统计、可视化分析、数据挖掘建模提供高质量数据源,是数据分析人员必须掌握的核心操作。
六、总结
Pandas DataFrame遍历修改包含iterrows、itertuples、loc索引、apply函数四大主流方式,各有适配场景。其中loc索引法精准通用、安全性最高,适配绝大多数精细化修改场景;apply函数简洁高效,是批量标准化修改的最优选择;iterrows适合新手入门操作;itertuples适配大数据量高效遍历。
在实际数据处理中,需规避临时数据修改失效、副本警告、数据类型错乱、索引错位等问题,遵循“批量修改用apply、精细修改用loc、大数据量用itertuples”的选型原则。熟练掌握各类遍历修改方法,能够高效完成数据清洗与数据优化工作,大幅提升Python数据分析的专业性与效率。
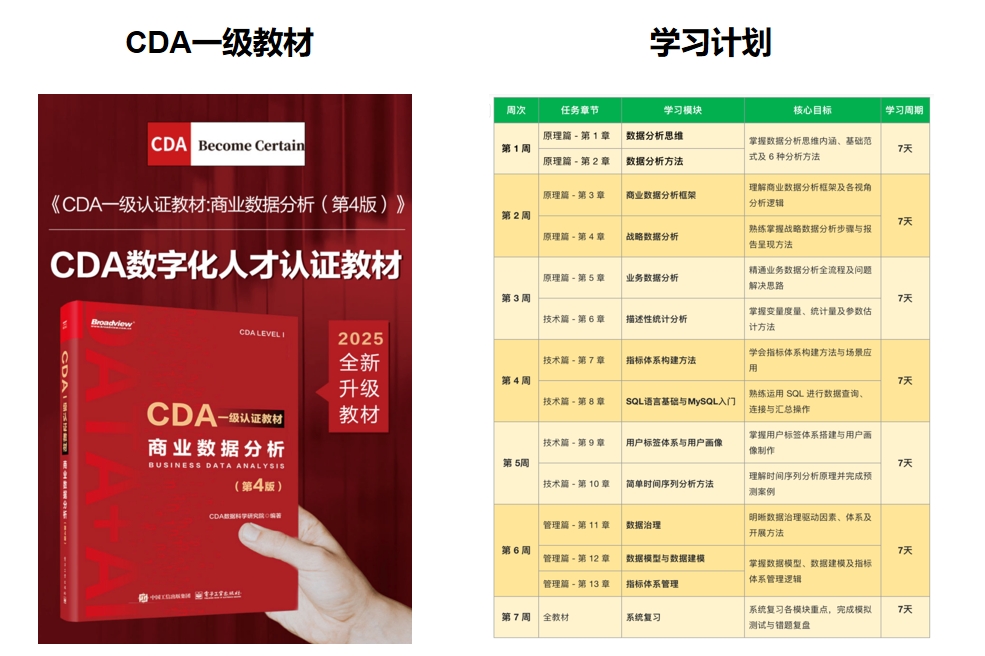
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330