启用HDFS文件系统之前,需要对其进行格式化;格式化只需做一次
在192.168.31.130上执行如下命令
cd /opt/linuxsir/hadoop/bin
./hdfs namenode -format
清理hadoop日志
rm -rf /opt/linuxsir/hadoop/logs/*.*
ssh root@192.168.31.132 rm -rf /opt/linuxsir/hadoop/logs/*.*
ssh root@192.168.31.133 rm -rf /opt/linuxsir/hadoop/logs/*.*
cd /opt/linuxsir/hadoop/sbin
./start-all.sh
\如果要停止,请执行如下命令
cd /opt/linuxsir/hadoop/sbin
./stop-all.sh
clear
cd /opt/linuxsir/hadoop/sbin
./start-dfs.sh
./start-yarn.sh
\如果要停止,请执行如下命令,即分开停止HDFS和YARN
cd /opt/linuxsir/hadoop/sbin
./stop-yarn.sh
./stop-dfs.sh
现在,可以在三个节点上,查看进程,验证Hadoop是否成功启动
[root@hd-master bin]
6262 NameNode
28630 Jps
6455 SecondaryNameNode
6618 ResourceManager
[root@hd-master bin]
3431 NodeManager
20697 Jps
3311 DataNode
[root@hd-master bin]
3313 DataNode
3431 NodeManager
20295 Jps
到目前为止,启动HDFS和YARN以后,各个节点的进程,如下图所示
| 层级 |
hd-master |
hd-slave1 |
hd-slave2 |
| hdfs层 |
NameNode、Secondary、NameNode |
DataNode |
DataNode |
| Yarn层 |
ResourceManager |
NodeManager |
NodeManager |
| hardware各个节点 |
192.168.31.131 |
192.168.31.132 |
192.168.31.133 |
在hd-master上运行如下命令,报告HDFS的基本信息
cd /opt/linuxsir/hadoop
./bin/hdfs dfsadmin -report
[root@hd-master bin]# cd /opt/linuxsir/hadoop
[root@hd-master hadoop]# ./bin/hdfs dfsadmin -report
Configured Capacity: 63116517376 (58.78 GB)
Present Capacity: 52430880768 (48.83 GB)
DFS Remaining: 52430462976 (48.83 GB)
DFS Used: 417792 (408 KB)
DFS Used%: 0.00%
Under replicated blocks: 2
Blocks with corrupt replicas: 0
Missing blocks: 0
Missing blocks (with replication factor 1): 0

-------------------------------------------------
Live datanodes (2):

Name: 192.168.31.133:50010 (hd-slave2)
Hostname: hd-slave2
Decommission Status : Normal
Configured Capacity: 31558258688 (29.39 GB)
DFS Used: 208896 (204 KB)
Non DFS Used: 5349883904 (4.98 GB)
DFS Remaining: 26208165888 (24.41 GB)
DFS Used%: 0.00%
DFS Remaining%: 83.05%
Configured Cache Capacity: 0 (0 B)
Cache Used: 0 (0 B)
Cache Remaining: 0 (0 B)
Cache Used%: 100.00%
Cache Remaining%: 0.00%
Xceivers: 1
Last contact: Fri Oct 11 01:29:14 PDT 2024


Name: 192.168.31.132:50010 (hd-slave1)
Hostname: hd-slave1
Decommission Status : Normal
Configured Capacity: 31558258688 (29.39 GB)
DFS Used: 208896 (204 KB)
Non DFS Used: 5335752704 (4.97 GB)
DFS Remaining: 26222297088 (24.42 GB)
DFS Used%: 0.00%
DFS Remaining%: 83.09%
Configured Cache Capacity: 0 (0 B)
Cache Used: 0 (0 B)
Cache Remaining: 0 (0 B)
Cache Used%: 100.00%
Cache Remaining%: 0.00%
Xceivers: 1
Last contact: Fri Oct 11 01:29:14 PDT 2024
使用日志
如果Hadoop启动出问题,可以通过查看日志来寻找原因。每次启动Hadoop,应该首先清空三个节点的logs目录,方便寻找错误。
当启动出错,可以到相应节点上,查看日志文件。哪个节点启动出错,就看哪个节点的日志文件。由于有无密码ssh登录,可以通过主节点登录到其它节点,去查看所有节点的日志文件。
日志文件分别在hd-master、hd-slave1、hd-slave2的/opt/linuxsir/hadoop/logs目录下。
启动Hadoop之前,删除log文件
如果启动出问题,log文件里就是最新的出错信息
rm -rf /opt/linuxsir/hadoop/logs/*.*
ssh root@192.168.31.132 rm -rf /opt/linuxsir/hadoop/logs/*.*
ssh root@192.168.31.133 rm -rf /opt/linuxsir/hadoop/logs/*.*
管理界面
若干web管理界面,列表如下
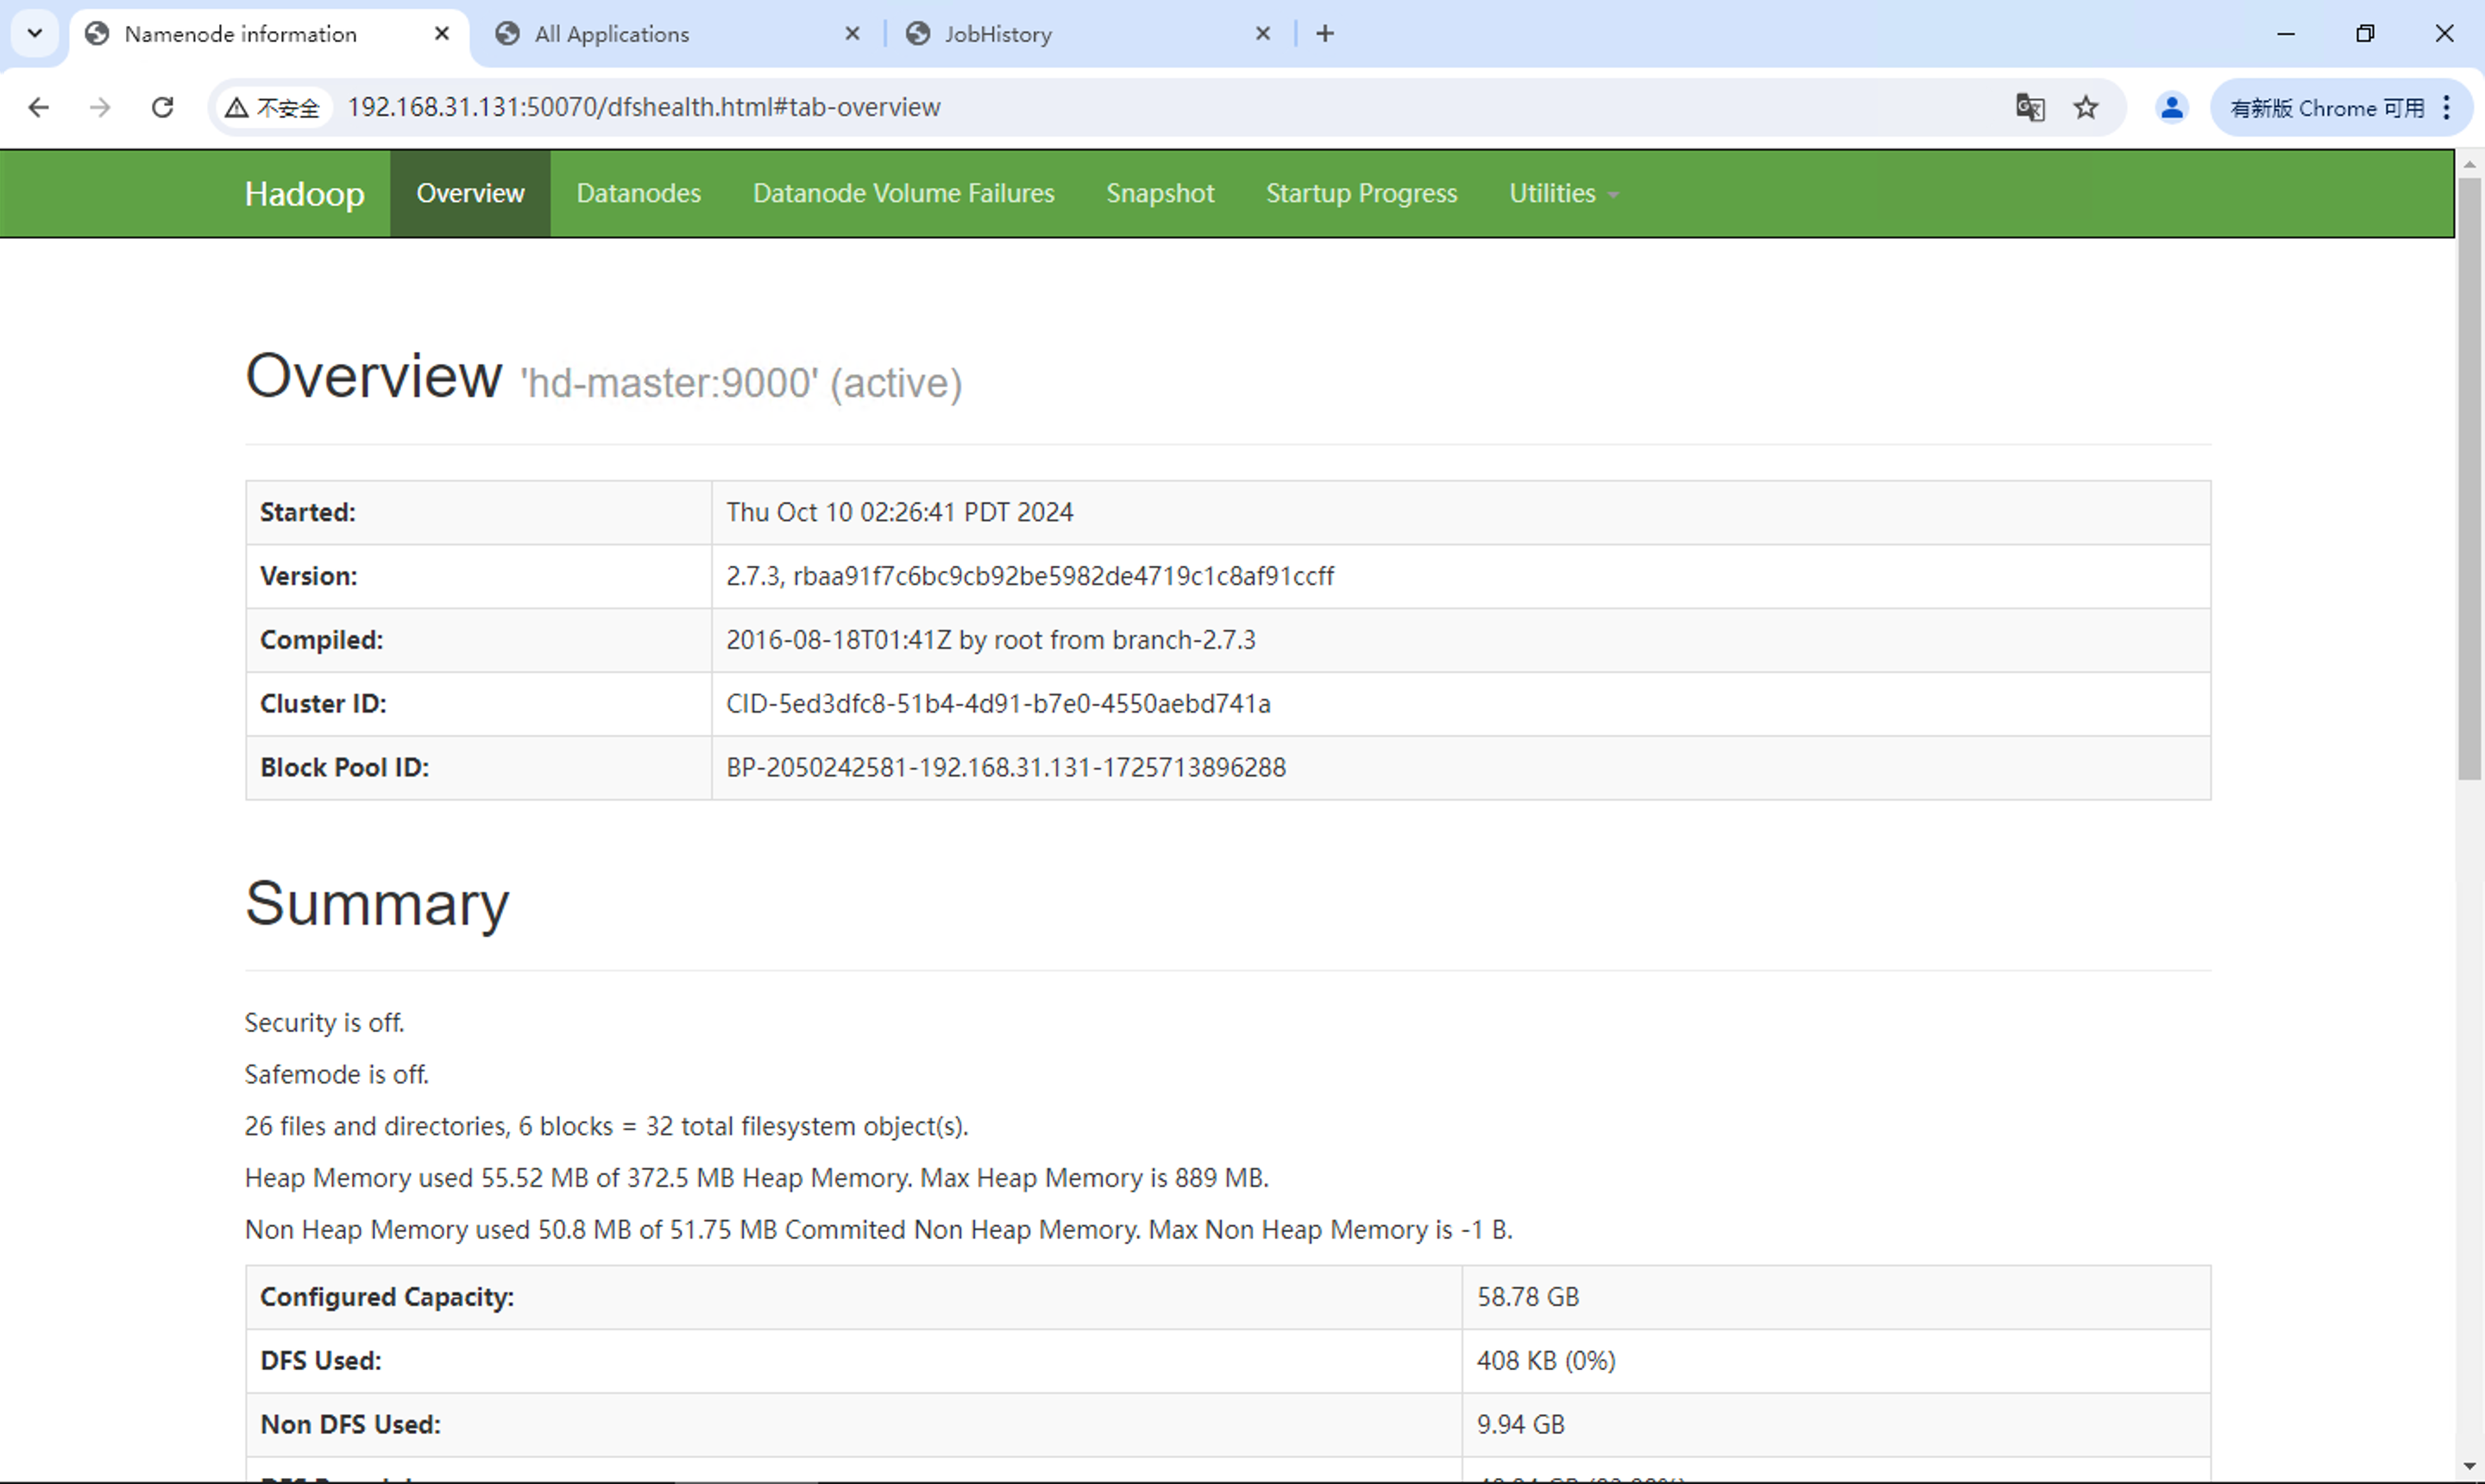
访问NameNode管理页面,监控文件系统。
http://192.168.31.131:50070/
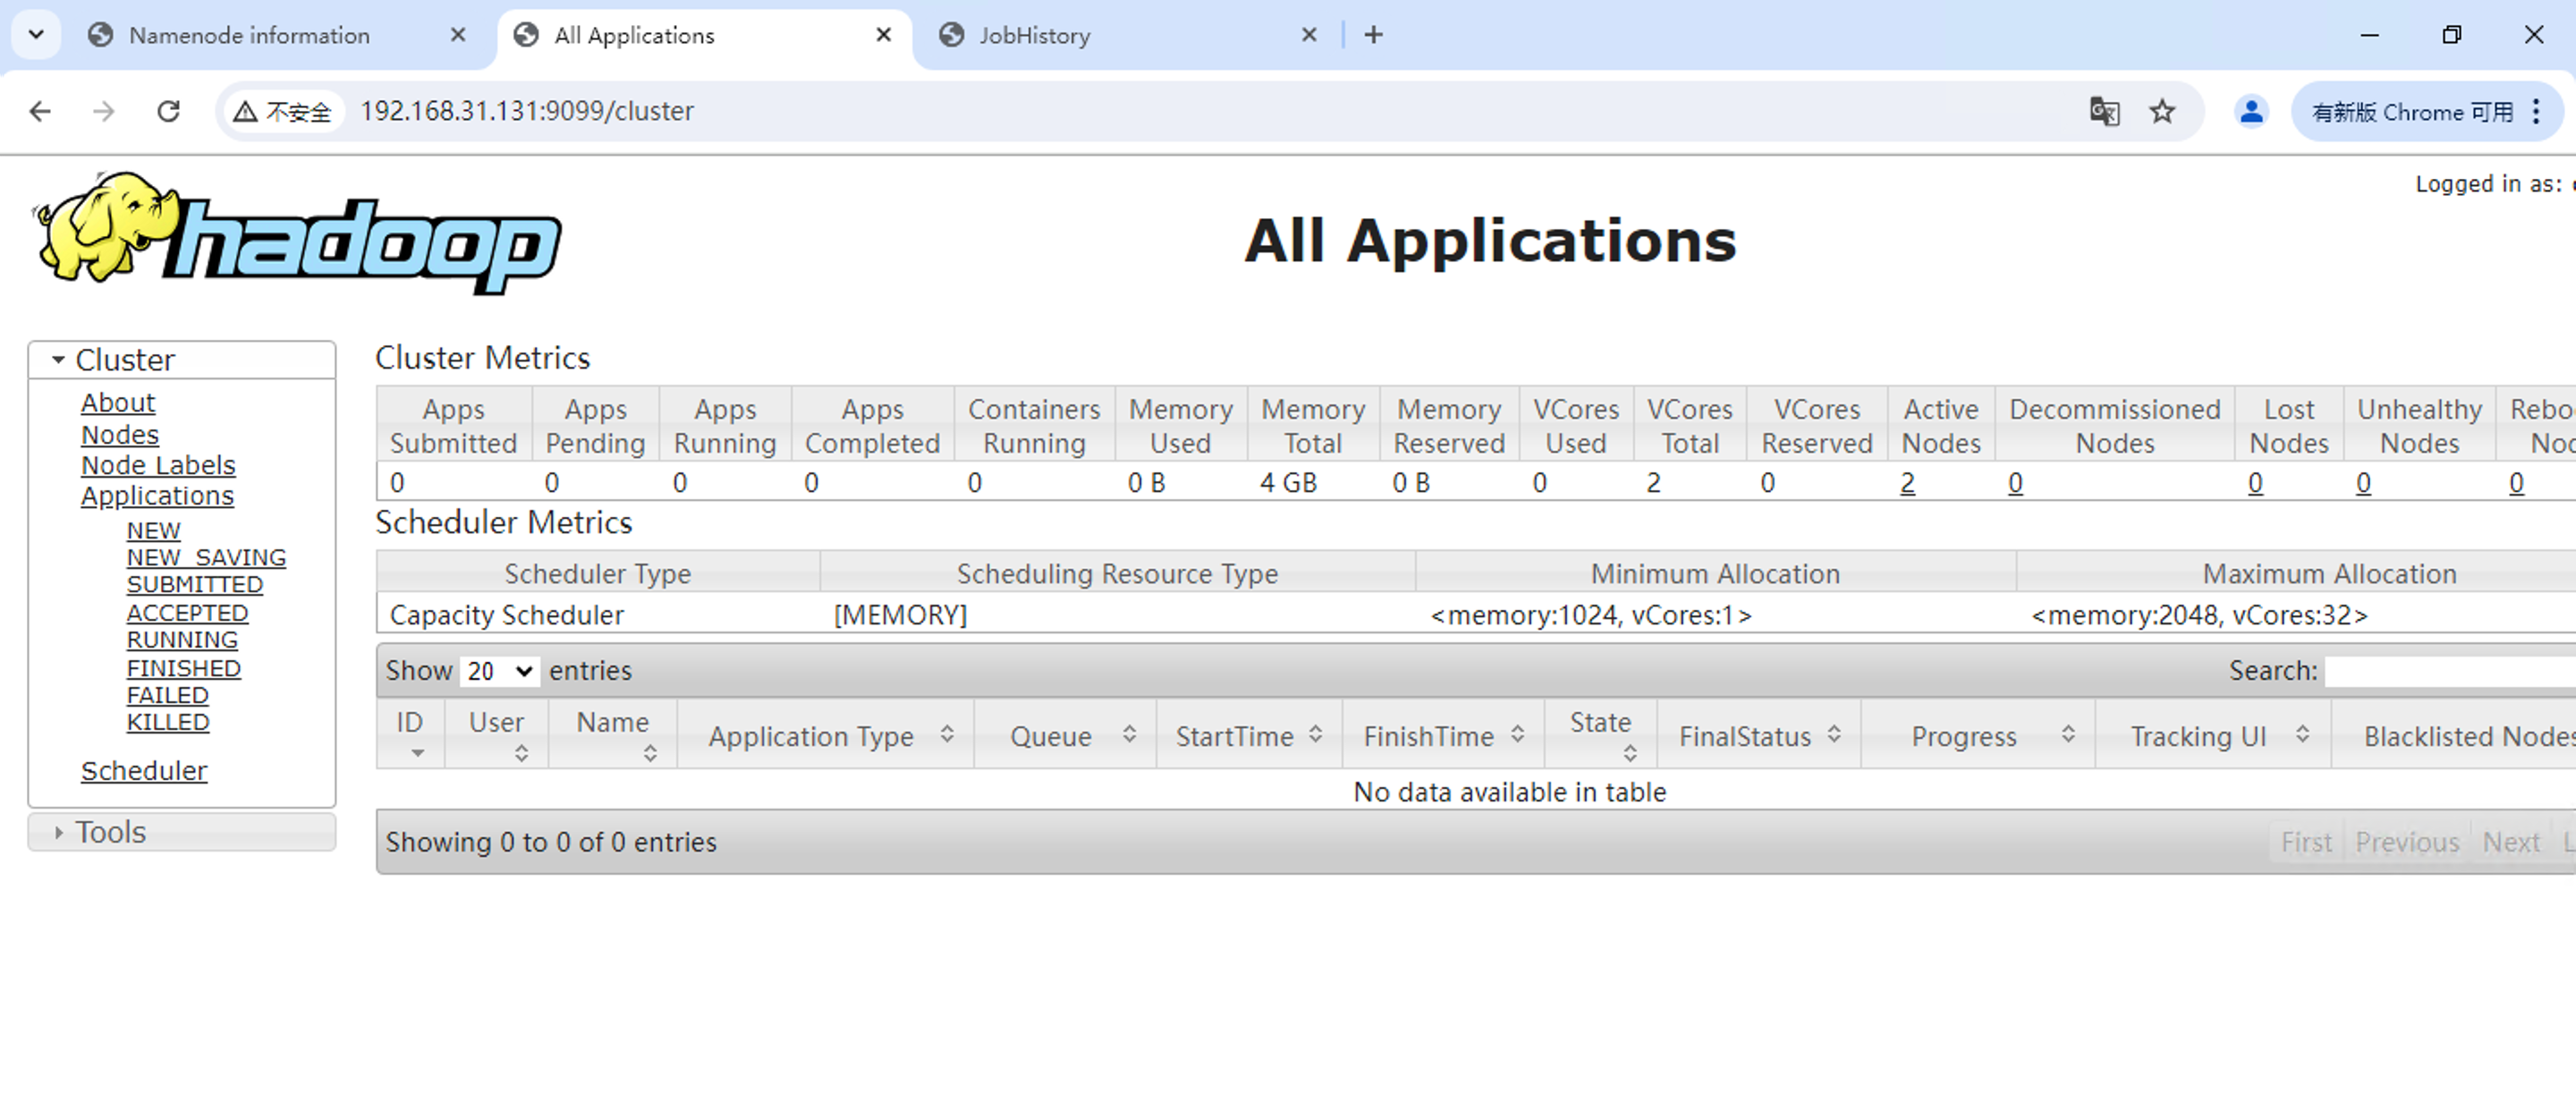
访问ResourceManager(整个Cluster)管理页面,监控集群状况。
http://192.168.31.131:9099/
这个端口缺省是8088,由于端口冲突,改成9099, 参考yarn-site.xml
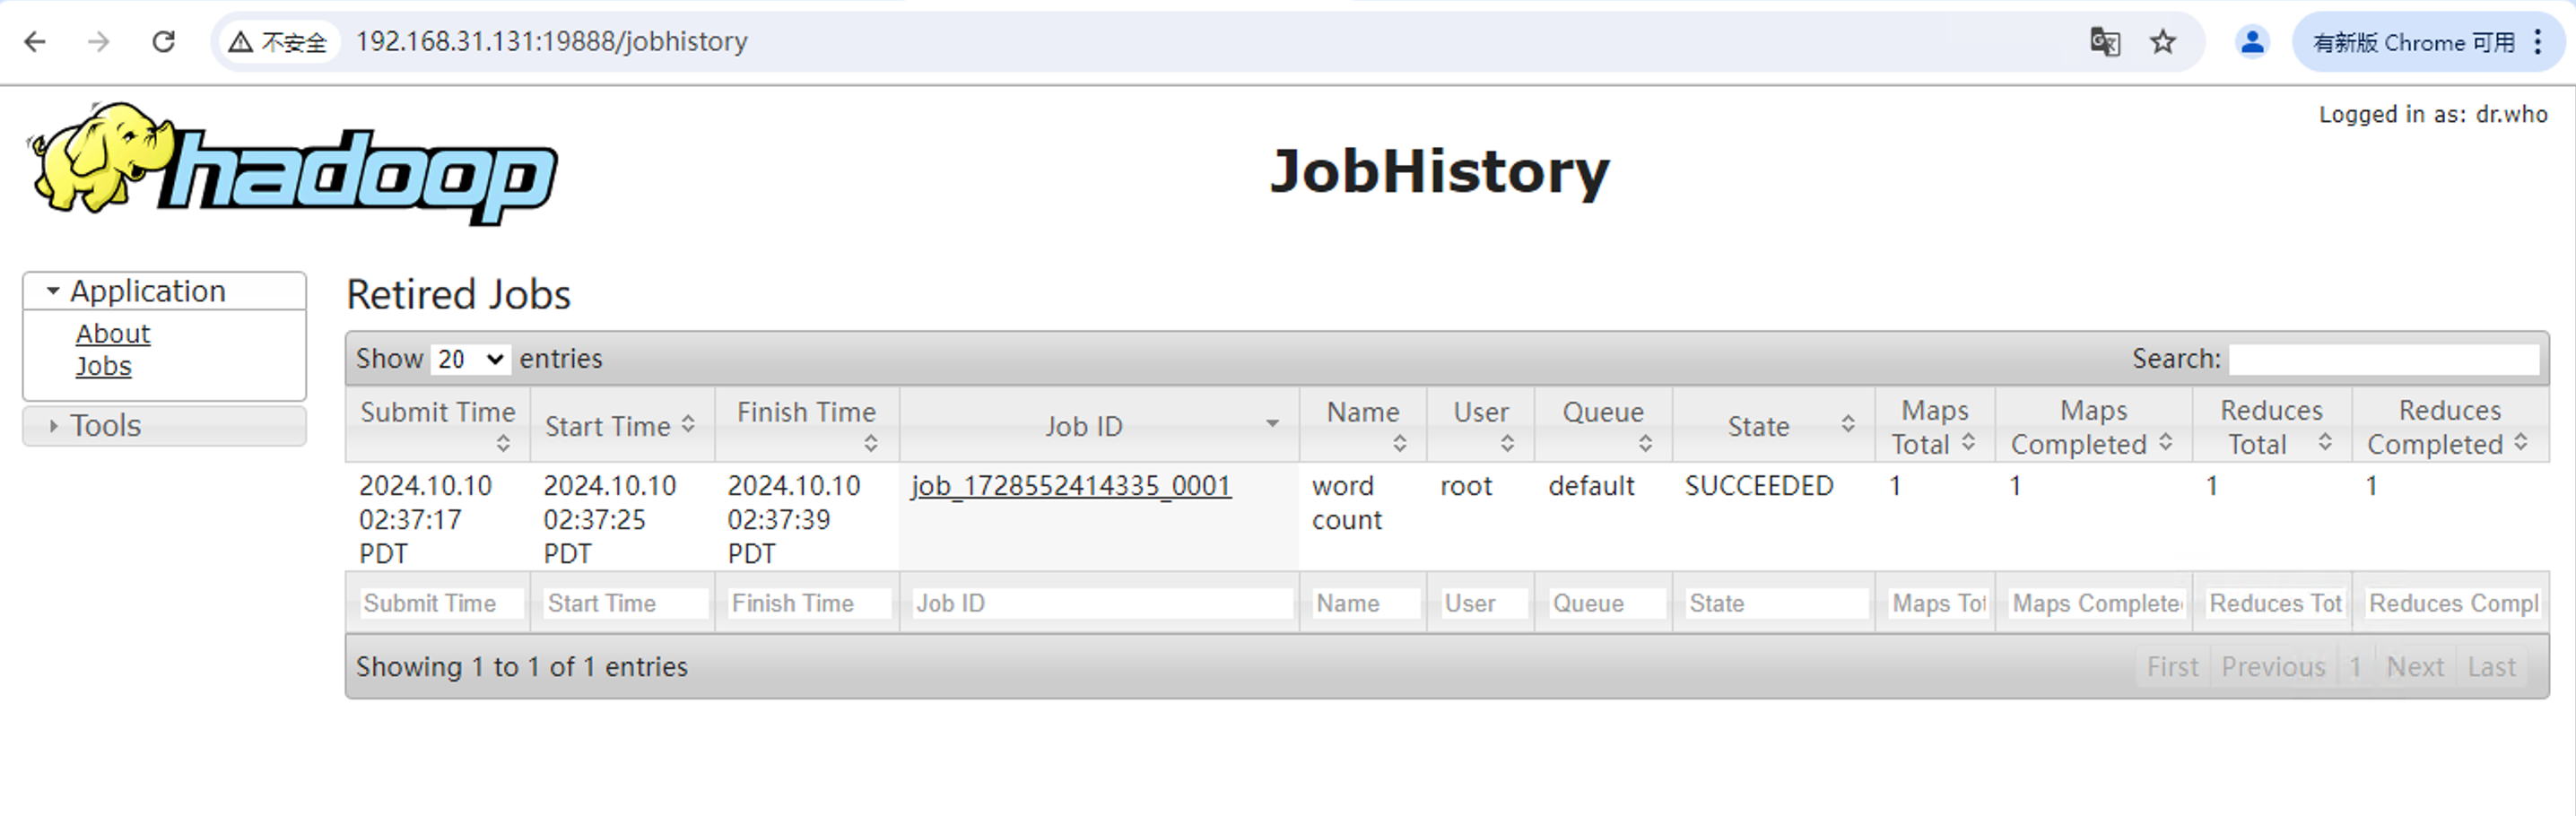
MapReduce JobHistory Server的管理页面,查看MapReduce作业提交历史;需要事先启动JobHistory Server。
http://192.168.31.131:19888/
HDFS 常用文件操作命令
cd /opt/linuxsir/hadoop/bin
hdfs dfsadmin -safemode leave
    \ 用户可以通过dfsadmin -safemode value 来操作安全模式,参数value的说明如下:
    \ enter - 进入安全模式
    \ leave - 强制NameNode离开安全模式
    \ get - 返回安全模式是否开启的信息
    \ wait - 等待,一直到安全模式结束

cd /opt/linuxsir/hadoop/bin
./hdfs dfs -rm -r /input                  \ 递归式删除目录
./hdfs dfs -mkdir /input                \ 创建目录
./hdfs dfs -chmod a+rwx /input          \ 授权

./hdfs dfs -mkdir /output               \ 创建目录
./hdfs dfs -copyFromLocal /opt/linuxsir/test.txt /input \ 拷贝文件到HDFS
\ 或者./hdfs dfs -put /opt/linuxsir/test.txt /input

./hdfs dfs -cat /input/test.txt | head        \ 显示文件的头几行
查看Wordcount MapReduce程序所需的数据
注意,需要事先启动HDFS和YARN
cd /opt/linuxsir/hadoop/bin
./hdfs dfs -cat /input/test.txt
./hadoop jar /opt/linuxsir/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-2.7.3.jar wordcount /input/test.txt /output
./hdfs dfs -ls /output
./hdfs dfs -cat /output/part-r-00000
为了运行wordcount,必须保证hdfs分布式文件系统的/output不存在。如果存在可以把它删除,命令如下
cd /opt/linuxsir/hadoop/bin
./hdfs dfs -ls /output

./hdfs dfs -rm /output/*
./hdfs dfs -rmdir /output
配置History Server
在hd-master节点上,配置History Server
1、在.../etc/hadoop/mapred-site.xml中配置以下内容
<property>
<name>mapreduce.jobhistory.address</name>
        <value>hd-master:10020</value>
</property>
<property>
        <name>mapreduce.jobhistory.webapp.address</name>
        <value>hd-master:19888</value>
</property>
2、把hd-master的新配置分发到所有节点即hd-slave1和hd-slave2。
clear

scp /opt/linuxsir/hadoop/etc/hadoop/mapred-site.xml hd-slave1:/opt/linuxsir/hadoop/etc/hadoop
scp /opt/linuxsir/hadoop/etc/hadoop/mapred-site.xml hd-slave2:/opt/linuxsir/hadoop/etc/hadoop
3、启动服务,在hd-master这台服务器上执行以下语句。
注意,需要事先启动HDFS和YARN
cd /opt/linuxsir/hadoop/sbin
mr-jobhistory-daemon.sh start historyserver

clear
jps
ssh root@192.168.31.132 jps
ssh root@192.168.31.133 jps
访问MapReduce JobHistory Server
http://192.168.31.131:19888/
为了顺利运行该实例,需要编辑/opt/linuxsir/hadoop/etc/hadoop/hdfs-site.xml配置文件,添加如下配置
<!-- for windows access linux HDFS -->
<property>
    <name>dfs.permissions.enabled</name>
    <value>false</value>
</property>
这里分享一个你一定用得到的小程序——CDA数据分析师考试小程序。
它是专为CDA数据分析认证考试报考打造的一款小程序。可以帮你快速报名考试、查成绩、查证书、查积分,通过该小程序,考生可以享受更便捷的服务。
扫码加入CDA小程序,与圈内考生一同学习、交流、进步!


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330